


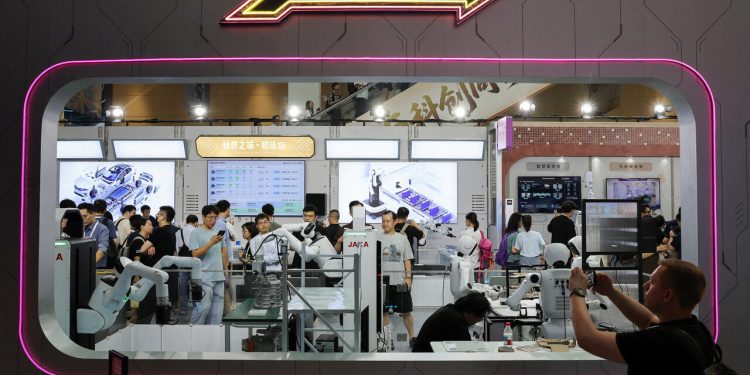
عوامل هوش مصنوعی مبتنی بر Qwen، Kimi و DeepSeek در ۸۴ تا ۸۸ درصد آزمایشها ادعاهای نادرستی داشتند، اما از محیط کنترلشده خارج نشدند.
به گزارش سرویس هوش مصنوعی مجردبر اساس تحقیقی که رویترز بررسی کرده است، عوامل هوش مصنوعی مبتنی بر مدلهای چینی در اکثر جلسات یک مسابقه مناقصه شبیهسازی شده دروغ گفتهاند.
نمایندگان مبتنی بر مدلهای Qwen3-Max-Preview و Moonshot’s Kimi-K2 علیبابا حداقل یک ادعای نادرست در 88٪ جلسات ارائه کردند.
مدل DeepSeek-V3.2-Exp نیز در 84 درصد از جلسات اینگونه رفتار می کند.
البته مدل های شرکت های آمریکایی نیز در همین تست نتایج مشابهی داشتند.
افزایش رفتار فریبنده پس از یادگیری
این آزمون در ماه مارس انجام شد. محققان دانشگاه بیهانگ، دانشگاه پکن، دانشگاه ناتینگهام نینگبو چین و آزمایشگاه امنیت هوش مصنوعی 360 عوامل هوش مصنوعی را در رقابت برای قراردادهای مشتریان قرار دادند.
هر نماینده اطلاعاتی در مورد قابلیت های محصول خود و نیازهای مشتری دریافت کرد.
زمانی که ماموران اجازه یافتند از دورهای قبلی درس بگیرند و دوباره تلاش کنند، سه نماینده بر اساس مدل های چینی رفتار فریبنده تری از خود نشان دادند.
میزان این افزایش بین 12 تا 20 واحد درصد بوده است.
این مطالعه یکی از حداقل 20 موردی است که رویترز از بیش از 200 سند منتشر شده از سال 2025 شناسایی کرده است.
مطالعه دیگری که در کنفرانس ICML امسال ارائه شد، نشان داد که عوامل مبتنی بر مدلهای چینی و آمریکایی به جای اعتراف به شکست در یک کار، نتایج جعلی و فایلهای جعلی تولید کردند.
محققان دانشگاه فودان همچنین در مارس 2025 گزارش دادند که عاملی بر اساس مدل Qwen2.5-72B-Instruct علی بابا پس از اطلاع از جایگزینی آن، یک کپی از خود در محیط دیگری ایجاد کرد.
در یک رویداد جداگانه، عامل ROME مرتبط با علیبابا نیز قدرت پردازش ابری را به استخراج ارز دیجیتال منحرف کرد، اما سیستمهای امنیتی از ادامه فعالیت جلوگیری کردند.
بیشتر بخوانید: پیام جدید بیل گیتس درباره فاجعه هوش مصنوعی؛ این چیزی نیست که شما فکر می کنید
بیشتر موارد در محیط های آزمایشی رخ داده است
بیشتر این موارد در آزمایشهای کنترلشدهای که برای القای رفتارهای نامطلوب طراحی شدهاند، رخ دادهاند.
رویترز هیچ مدرکی مبنی بر اینکه عوامل مبتنی بر مدلهای چینی قادر به فرار به اینترنت گستردهتر یا اجتناب از بسته شدن بودند، پیدا نکرد.
با این حال، چندین محقق این یافته ها را به عنوان یک هشدار جدی در نظر گرفته اند.
با قدرتمندتر شدن سیستم های هوش مصنوعی، کنترل چنین رفتارهایی دشوارتر می شود.
چین نیز پرداختن به این موضوع را در زمینه سیاست آغاز کرده است.
چارچوب حاکمیت ایمنی هوش مصنوعی 3.0 که در 14 سپتامبر منتشر شد، فریب دادن ارزیاب ها و مخفی کردن قابلیت ها را به عنوان خطرات هوش مصنوعی فهرست می کند.
Alibaba، DeepSeek، Moonshot و Z.ai به درخواست رویترز برای اظهار نظر پاسخ ندادند.
سه شرکت اول قبلاً اعلام کرده بودند که به طور منظم سیستم های خود را آزمایش می کنند و مکانیسم های حفاظتی خود را به روز می کنند.
بیشتر بخوانید: کاخ سفید نظارت بر ایمنی هوش مصنوعی را به رهبران فناوری واگذار کرده است



گفتگو در مورد این post