
رونمایی از سری مدل Maestro توسط Cadence گامی استراتژیک برای تحول هوش مصنوعی عامل گرا در طراحی تراشه خواهد بود.
به گزارش سرویس هوش مصنوعی تکناک، کادنس، یکی از بزرگترین بازیگران صنعت اتوماسیون طراحی الکترونیکی (EDA) با معرفی مجموعه ای از مدل های تخصصی Maestro برای پشتیبانی از عوامل طراحی تراشه، رویکرد جدیدی را برای غلبه بر هزینه های سنگین پردازش و افزایش بهره وری در صنعت نیمه هادی ها به نمایش گذاشت. هدف این مجموعه تخصصی با استفاده از معماری ترکیبی، یادگیری تقویتی و سازگاری با زیرساخت های پردازشی مختلف، کاهش چشمگیر مصرف توکن و بهبود کارایی در مقایسه با مدل های هوش مصنوعی عمومی است.
صنعت اتوماسیون طراحی الکترونیکی در سال های اخیر موجی از تقاضا برای توسعه تراشه های پیشرفته را تجربه کرده است. فرآیند طراحی و اعتبارسنجی مدارهای مجتمع با پیچیدگی محاسباتی زیادی همراه است که بخش بزرگی از توان تیم های مهندسی را به خود اختصاص می دهد. ورود عوامل مستقل هوش مصنوعی به این چرخه ابتدا به عنوان راه حلی برای آزادسازی ظرفیت انسانی و افزایش سرعت عرضه محصول مطرح شد، اما گسترش استفاده از این سیستم ها چالش های جدیدی را به همراه داشت. استفاده از مدلهای زبان عمومی برای هدایت ابزارهای طراحی تخصصی هزینههای پردازش هنگفتی را به دلیل نیاز مکرر به فراخوانی و ارسال داده، بر جای میگذارد. بر این اساس، توسعه مدل هایی که به صورت بومی برای محیط های EDA آموزش داده شده اند، به یک ضرورت اجتناب ناپذیر در دستور کار رهبران صنعت تبدیل شده است.
Cadence اعلامیه Maestro را اندکی قبل از گزارش مالی خود اعلام کرد. بر اساس اطلاعات اعلام شده در این بیانیه، بررسی های اولیه نشان می دهد که این مدل های تخصصی می توانند کیفیت نتایج را تا 30 درصد در مراحل مختلف طراحی نسبت به یک مدل پایه عمومی بهبود بخشند. علاوه بر این، نحوه تعامل Maestro با ابزارهای تخصصی به گونه ای بهینه شده است که انجام یک کار معین به توکن های کمتری نیاز دارد که کارایی مدل را در استفاده از توکن ها تا پنج برابر افزایش می دهد. اولین گروه از این مدل ها قرار است در سه ماهه چهارم سال 2026 برای مشتریان منتخب با دسترسی زودهنگام در دسترس قرار گیرند. کاربران می توانند این مدل ها را در ابر Cadence، سرویس های ابری عمومی یا مراکز داده مدیریت شده خودشان مستقر کنند و با تکیه بر داده ها، طرح ها و گردش کار محرمانه خود، آموزش های اضافی را روی آنها پیاده سازی کنند.
ترکیبی از عوامل هوشمند و مدل های تخصصی
پل کانینگهام، معاون ارشد و مدیر کل کادنس در گفتوگوی تحلیلی درباره دلایل حرکت به سمت این رویکرد تاکید کرد که هزینههای استفاده مستمر از عوامل هوش مصنوعی افزایش بیسابقهای پیدا کرده و فعالان این حوزه را نگران کرده است. به گفته وی، زمانی که یک نماینده بخواهد تمام آزمون و خطاها و استدلال های خود را با کمک مدل های عمومی و بر اساس تبادل پیام های مکرر انجام دهد، هزینه های نهایی با سرعت باورنکردنی رشد می کند. راه حل منطقی در چنین شرایطی انتقال بخش عمده ای از تصمیمات، دانش تجربی و محاسبات مکرر به وزن های داخلی خود مدل است. با این روش مدل به جای آزمون و خطای زمان بر در محیط خارجی، منطق حاکم بر ابزارهای طراحی را از ابتدا در ساختار محاسباتی خود گنجانده و برای دریافت پاسخ های اولیه نیازی به ارسال مکرر داده ها نیست.
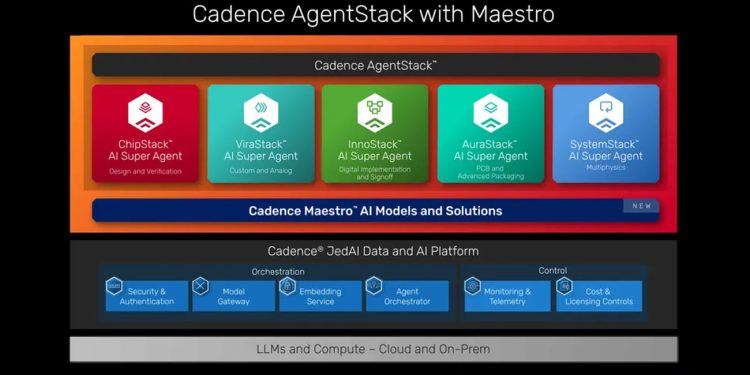
مجموعه Maestro بر اساس ساختار AI Super Agents Cadence سازماندهی شده است. این عوامل پیشرفته ابتدا قصد اصلی طراحان را تفسیر می کنند، سپس وظایف بزرگ و پیچیده را به مراحل کوچکتر و عملیاتی تقسیم می کنند و بین مدل های Maestro و سایر مدل های مرزی و مدل های وزن باز هماهنگ می کنند. این سیستم با تکیه بر تجربیات فنی عمیق، مبادلات بین پارامترهای مختلف را در مسیر تصمیمات مهندسی حیاتی ارزیابی می کند. در کنار این قابلیت ها، استفاده از یادگیری تقویتی (RL) ستون فقرات عملکرد این مجموعه را تشکیل می دهد. در این روش، حلکنندههای قطعی Cadence خروجیهای تولید شده را در برابر اهداف مهندسی، محدودیتهای فنی و واقعیتهای فیزیکی اعتبارسنجی میکنند. نتایج بهدستآمده از این اندازهگیریهای دقیق مجدداً بهعنوان دادههای تنبیهی یا انگیزشی وارد ساختار مدل میشود تا دقت آن در مراحل بعدی به طور مداوم بهبود یابد.
ادغام با مدل Nemotron انویدیا
یکی از نکات برجسته در ساختار فنی این سیستم، یکپارچگی آن با مدل Nemotron انویدیا است. مشتریان می توانند با استفاده از چارچوب تنظیم دقیق انحصاری Cadence، آموزش های اضافی را با داده های داخلی خود انجام دهند و حتی این فرآیند را بر روی کارت های گرافیک و شبکه محلی خود بدون خروجی داده اجرا کنند. به گفته مدیران Cadence، عملکرد Nemotoron در آزمایشهای اخیر نتایج بسیار پایداری را نشان داده است و روند بهبود کارایی آن با سرعت بیسابقهای در حال پیشرفت است.
در زمینه ابزارهای EDA، معیارهای ارزیابی عددی همیشه به دقت بالایی نیاز دارند. اصطلاح کیفیت نتایج در مهندسی مدارهای مجتمع معمولاً به سه جزء اساسی اشاره دارد: مصرف انرژی، عملکرد پردازش و مساحت تراشه (PPA)، اگرچه Cadence هنوز تعیین نکرده است که آیا رقم بهبود 30 درصد ترکیبی از این متغیرها است یا متعلق به یک شاخص خاص است. علاوه بر این، بهبود پنج برابری در بهرهوری توکن در مقایسه با مدل اندازهگیری شده پایه که استاد اصلی بر روی آن آموزش دیده بود، ادعا شده است. اگرچه Cadence نام این مدل پایه منبع باز را فاش نکرد، اما یکی از برجسته ترین مدل های منبع باز محسوب می شود که نتایج چشمگیری در رقابت با مدل های تجاری در بازار به ثبت رسانده است.
بر اساس این گزارش تامز هاردورصرفه جویی در رمز در سیستم Maestro تا حد زیادی به دلیل تقسیم هوشمند کار بین ابزارهای طراحی است. این پلتفرم تعادل خوبی بین فراخوانی ابزار طراحی الکترونیکی (EDA)، سیستمهای اتوماسیون طراحی سیستم (SDA) و استفاده از مدلهای زبانی در مقیاس بزرگ (LLM) برقرار میکند. به گفته مدیران Cadence، دلیلی برای استفاده از موتور جت برای رسیدن به یک مقصد معمولی درون شهری وجود ندارد. بلکه هنر طراحی مهندسی این است که از مدل مناسب در لحظه مناسب و برای کار مناسب استفاده کنید. از سوی دیگر، عامل زمان در ابزارهای EDA نقش تعیین کننده ای دارد. راب نات، مدیر ارشد استراتژی و کسبوکارهای جدید در Cadence، توضیح میدهد که فراخوانی یک ابزار شبیهسازی یا طراحی میتواند از چند ساعت تا چند روز طول بکشد تا یک عدد را محاسبه و برگرداند، در حالی که حلقههای پردازش هوش مصنوعی برای مقیاسهای چند دقیقه تنظیم میشوند. مدیریت این تفاوت قابل توجه مستلزم زمان بندی دقیق در اجرای نرم افزار است تا هزینه های اشتراک مشتریان نیز در سطح متعادلی مهار شود.
رقابت Cadence و Synopsys در طراحی تراشه
در طرف دیگر میدان، شرکت رقیب Synopsys نیز استراتژی خود را بر اساس پلتفرم Autopilot و همکاری نزدیک با OpenAI تعریف کرده است. با وجود این همسویی در استفاده از عوامل هوشمند، تفاوت اساسی در زمینه مدیریت و ذخیره سازی داده های طراحی مشتری بین این دو غول صنعت وجود دارد.
| شاخص مقایسه | Cadence Maestro | GPT-Synopsys |
|---|---|---|
| تاریخ اعلام | 26 اکتبر 2026 | 30 سپتامبر 2026 |
| تعریف محصول | مجموعه ای از مدل های تخصصی هوش مصنوعی برای پشتیبانی از Super Agents AI Cadence | مدلی تخصصی برای هدایت و پیاده سازی مستقیم ابزارهای نرم افزار سینوپسیس |
| شریک توسعه مدل | Nvidia (شامل مدل Nemotron و معماری OpenShell) | OpenAI |
| ساختار مدل ها | مدل های زبان آموزش دیده، مدل های تصمیم گیری و مهارت های عامل، همراه با مدل های رایگان مانند Nemotron | مدلهای زبان مرزی OpenAI |
| محیط اجرای پردازش | فضای ابری خصوصی، ابر عمومی یا محیط های داخلی تحت کنترل مشتری را تغییر دهید | زیرساخت میزبانی شده بر روی سرورهای OpenAI |
| خط مشی داده های مشتری | امکان آموزش تکمیلی مدل ها در مورد داده ها و طرح های مشتری با ابزارهای تنظیم دقیق | عدم استفاده از داده های طراحی مشتری برای آموزش مدل ها |
| نتایج آزمایشی اعلام شد | تا 30 درصد بهبود کیفیت و تا 5 برابر بهره وری توکن در مقایسه با مدل منبع باز اصلی در اولین آزمایش ها | آمار رسمی منتشر نشده است |
| برنامه تحویل | تحویل اولین مدل ها به مشتریان دسترسی زودهنگام در سه ماهه چهارم سال 2026 | بدون تاریخ مشخص؛ آغاز همکاری فنی اولیه |
| مشتریان و شرکا | Socionext، Silicon Labs، Leading Labs و همکاری فنی با Nvidia | هنوز نامی اعلام نشده است |
| روش قیمت گذاری | اشتراک با محدودیت استفاده مشخص و دریافت هزینه برای استفاده مازاد | نامشخص؛ مدل تقسیم درآمد بین Synopsys و OpenAI |
موضوع امنیت و حفاظت از مالکیت معنوی همواره یکی از دغدغه های حیاتی سازندگان تراشه است. برای رفع این نگرانی، Cadence با Nvidia همکاری کرده است تا سیستم خود را با معماری مرجع OpenShell هماهنگ کند. این پلتفرم که هفته گذشته توسط انویدیا رونمایی شد، استانداردهای سختگیرانه ای را برای ایجاد محیط های ایزوله پردازشی ارائه می کند تا اسرار طراحی مشتریان از هرگونه نشت اطلاعات در امان باشند.
توسعه زیرساخت هوش مصنوعی Cadence
پیشرفت Cadence در توسعه عوامل هوش مصنوعی خودمختار یک روند مداوم را در دوازده ماه گذشته نشان می دهد. پس از خرید استارت آپ ChipStack در نوامبر 2025، این شرکت به سرعت خانواده نمایندگی های تخصصی خود را گسترش داد و اکنون سری مدل Maestro به عنوان موتور محرکه همه این زیرساخت ها عمل می کند.
| زمان | نام محصول | ادعای عملکردی آهنگ | وضعیت فعلی و اقدامات آتی |
|---|---|---|---|
| نوامبر 2025 | دستیابی به چیپ استک (راه اندازی اعتبار سنجی کارخانه) | – | تکمیل شد؛ انتصاب یکی از بنیانگذاران ChipStack به عنوان مدیر گروه تحقیقاتی هوش مصنوعی |
| فوریه 2026 | ChipStack AI Super Agent | تا 10 برابر بهره وری در برنامه نویسی طراحی، محیط تست، برنامه ریزی تست و اشکال زدایی | در مرحله دسترسی اولیه از زمان معرفی |
| آوریل 2026 | معرفی ViraStack، InnoStack و AgentStack | – | اجرای عملیاتی InnoStack توسط Socionext. وضعیت سایر موارد نامشخص است |
| ژوئن 2026 | ChipStack را با همکاری Nemotoron به سطح 5 ارتقا دهید | شتاب بیش از 40 برابری چرخه های اعتبارسنجی RTL در زیرساخت Nvidia | انتشار سطح 5 و عامل AgentStack در نیمه دوم سال 2026 برای پذیرندگان اولیه |
| جولای 2026 | معرفی پایگاه داده AuraStack برای بسته بندی پیشرفته و PCB | تا 2 برابر سرعت بیشتر در عرضه محصول و 15 برابر بهره وری بیشتر | موجود در ابررایانه Millennium M2000. شروع پیاده سازی توسط نوکیا |
| سپتامبر 2026 | عامل تولید خودکار RTL در پلتفرم ChipStack | به طور متوسط 24 درصد کاهش مساحت و 18 درصد کاهش قدرت نسبت به مدل های عمومی | ارائه به کاربران اولیه در سه ماهه چهارم سال 2026؛ همکاری اولیه با واحد تحقیق و توسعه هوندا |
| 26 اکتبر 2026 | رونمایی از نمونه کار مدل های هوش مصنوعی Maestro | تا 30 درصد بهبود در کیفیت نتایج و تا 5 برابر بهره وری توکن در ارزیابی های اولیه | عرضه نسخه های اولیه در سه ماهه چهارم سال 2026 با حضور حدود 12 شرکت همکار |
سرعت سرسام آور این پیشرفت ها مرز بین مرحله دسترسی اولیه و انتشار گسترده تجاری را دوچندان کرده است. علیرغم تعاملات گسترده هر دو شرکت با شرکای صنعتی، پلت فرم های مهندسی خودکار هنوز در میانه تکامل هستند و زمان دقیق معرفی تجاری و عمومی آنها به نتایج عملیاتی در مقیاس صنعتی بستگی دارد. آنچه واضح است حرکت اساسی غول های نیمه هادی به سمت محلی سازی عمیق هوش مصنوعی در قلب ابزارهای مهندسی است. تغییری که می تواند به طور غیرقابل برگشتی نقشه راه تولید تراشه های آینده را تغییر دهد.



گفتگو در مورد این post