


گوگل از دو مدل جدید تبدیل متن به گفتار، Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS رونمایی کرد و گفت این محصولات تولید صدا را از مجموعه ای از صداهای ایستا و آماده به محیطی خلاقانه و پویاتر تبدیل می کنند.
به گزارش سرویس هوش مصنوعی Technak، این شرکت می گوید که مدل های جدید برای تولید تجربیات صوتی طبیعی و بیان محور طراحی شده اند و در Google AI Studio، Gemini API، Gemini Enterprise، Gemini Notebook و Google Vids استفاده می شوند.
گوگل اعلام کرد این دو مدل برای گروه های مختلف کاربران ساخته شده اند. Flash TTS بیشتر بر طراحی شخصیت های صوتی و کارگردانی خلاقانه تمرکز دارد و Flash-Lite TTS برای تولید انبوه، دوبله گسترده و استفاده مقرون به صرفه در مقیاس بالا در نظر گرفته شده است.
روی ایجاد صداهای تازه و سفارشی سازی گسترده تمرکز کنید
یکی از مهم ترین ویژگی های Gemini 3.8 Flash TTS ایجاد صدای دلخواه از ابتدا می باشد. گوگل می گوید که کاربران می توانند با استفاده از دستور زبان طبیعی زبان، نقش، لهجه و ویژگی های صدای مورد نظر را تعریف کرده و یک کاراکتر صوتی جدید ایجاد کنند. این ویژگی برای بازی ها، کتاب های صوتی، پادکست ها و رسانه های تعاملی در نظر گرفته شده است.
گوگل می گوید این ویژگی در بیش از 100 زبان و گویش کار می کند. به گفته این شرکت، کاربر می تواند برای یک شخصیت در یک نمایش، یک راوی با لهجه منطقه ای، یا حتی یک روبات با صدای یکنواخت، صدایی طراحی کند. به گفته گوگل، این ویژگی نشان می دهد که تولید صدا دیگر محدود به انتخاب از چند گزینه محدود نیست.
گوگل علاوه بر ایجاد صداهای جدید، کتابخانه ای با بیش از 2000 صدای آماده را نیز اعلام کرده است. این مجموعه زبانها و انواع منطقهای، از جمله نمونههایی مانند اسپانیایی مکزیکی، فرانسوی کبکی و انگلیسی اسکاتلندی را پوشش میدهد. گوگل می گوید که این تنوع به کاربر این امکان را می دهد که بسته به نیاز پروژه، بین استفاده از صدای آماده یا طراحی هویت صوتی جدید یکی را انتخاب کند.
یکی دیگر از قابلیت های معرفی شده شبیه سازی صدا است. گوگل می گوید یک کاربر می تواند با یک نمونه 30 ثانیه ای از صدای خود یا صدایی که حق استفاده از آن را دارد، یک نمایه صدای ثابت ایجاد کند. این شرکت همچنین اعلام کرده است که کاربران می توانند صداهای ایجاد شده را ذخیره و مدیریت کنند تا در پروژه های بعدی همان کیفیت و شخصیت صدا را حفظ کنند.
کنترل دقیق اجرا و هدایت دیالوگ ها
گوگل می گوید هر دو مدل جدید تنها برای ایجاد صدای جدید نیستند، بلکه امکان کنترل اجرای متن را نیز فراهم می کنند. پس از انتخاب صدا، کاربر می تواند نشانه ها و دستوراتی را برای هر خط از اسکریپت بنویسد تا مدل، لحن و بیان را بر اساس آن تنظیم کند. این ویژگی را می توان برای صحنه های آرام، دیالوگ های پر تعلیق یا مکالمات تعاملی استفاده کرد.
به گفته گوگل، Flash TTS همچنین از تولید محتوای طولانی مدت پشتیبانی می کند و می تواند کیفیت صدا، سرعت گفتار طبیعی و تایم آوازی کاراکتر را طی چندین ساعت صدای مداوم حفظ کند.
یکی دیگر از ویژگی های برجسته صحنه سازی بومی برای دو سخنران است. گوگل می گوید کاربران می توانند یک مکالمه چند مرحله ای را در یک اسکریپت تعریف کنند و این مدل به طور طبیعی چرخش های مکالمه را بین دو صدا انجام می دهد.
گوگل همچنین بر امکان افزودن نشانه های غیرکلامی و واکنش های کوتاه تاکید کرده است. با توجه به توضیحات شرکت، کاربر می تواند نشانه هایی مانند خنده، آه یا نفس نفس زدن ناگهانی و واکنش هایی مانند “هوم” یا “بله” را وارد کند تا لایه طبیعی تری به عملکرد اضافه کند.
مدل Lite برای مقیاس بالا و هزینه کمتر
در کنار مدل اصلی، گوگل از Gemini 3.8 Flash-Lite TTS به عنوان گزینه ای برای تولید صدای با حجم بالا نام می برد. به گفته این شرکت، این مدل برای دوبله گسترده، تولید محتوای صوتی و ایجاد عامل صوتی طراحی شده است، در حالی که همچنان به کاربر امکان کنترل لحن، سرعت و ظرافت های بیان را می دهد.
گوگل می گوید تفاوت اصلی بین Flash-Lite TTS و مدل Flash TTS تمرکز آن بر هزینه و مقیاس است. به عبارت دیگر، این مدل برای شرایطی ساخته شده است که سازمان یا توسعه دهنده نیاز به تولید تعداد زیادی فایل صوتی یا ارائه خدمات صوتی در مقیاس بزرگ دارد.
این شرکت در معرفی مدل لایت بر کاربردهای کاربردی آن تاکید کرده است. از دیدگاه گوگل، دوبله محتوای چندزبانه، تولید محتوای صوتی با حجم بالا و توسعه عوامل صوتی بیان محور از مهم ترین زمینه هایی است که می توان از این مدل استفاده کرد.
گوگل این دو مدل را نیز در کنار دیگر محصولات صوتی خود معرفی کرده است. به گفته این شرکت، انتشار آنها به دنبال معرفی 3.5 Live Translate، 3.5 Transcribe، 3.8 Live و 3.8 Live Extended Thinking است.
بیشتر بخوانید: گوگل اپلیکیشن گفتار به متن هوشمند آفلاین را راه اندازی کرد
نتایج ارزیابی و پشتیبانی گسترده زبان
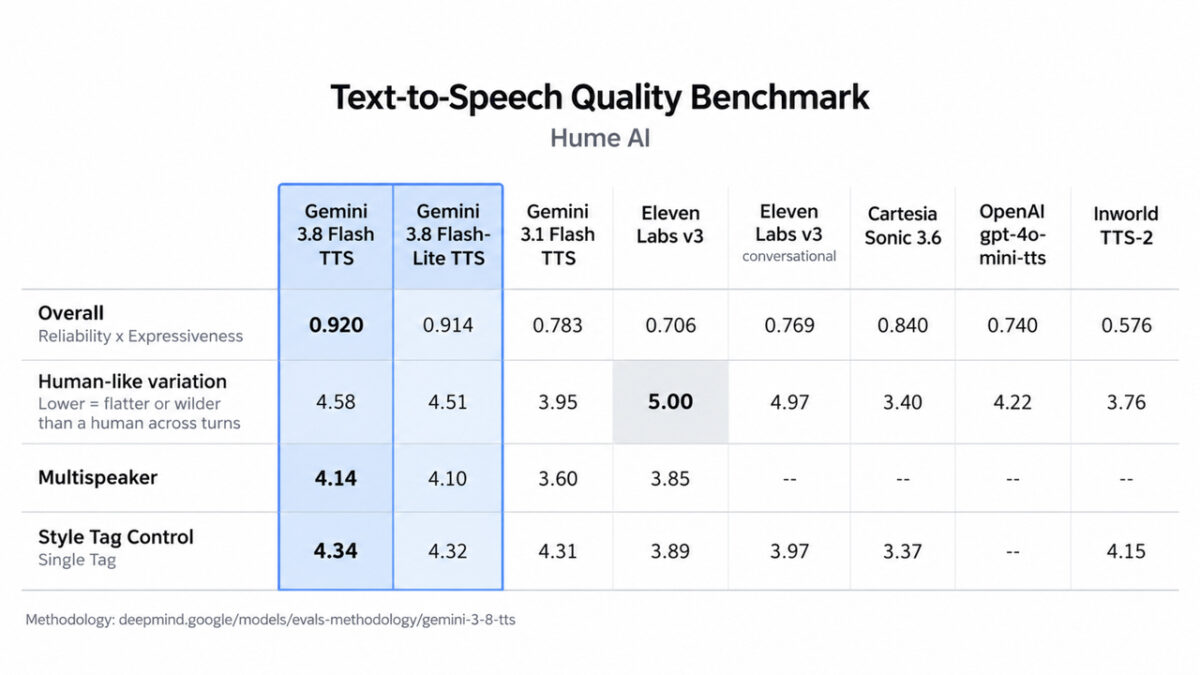
گوگل در بخشی دیگر از معرفی این محصولات به نتایج چندین ارزیابی خارجی اشاره کرده است. بر اساس اعلام این شرکت، Gemini 3.8 Flash TTS با امتیاز 71.4 در رتبه اول بنچمارک طراحی صوتی Hume AI قرار گرفته است. گوگل همچنین گفته است که این مدل در زمینه شبیه سازی لهجه با امتیاز 60.8 مقام اول را کسب کرده است.
این شرکت اضافه کرد که Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS نیز مقام های اول و دوم را در شاخص کیفیت کلی مربوط به هوش مصنوعی Hume کسب کرده اند. گوگل میگوید این نتایج نشان میدهد که مدلهای جدید بدون به خطر انداختن ثبات و قابلیت اطمینان، عملکرد واضحی را ارائه میدهند.
گوگل همچنین اعلام کرده است که مدلهای جدید نسبت به Gemini 3.1 Flash TTS در برخی برنامهها، مانند محتوای طولانی و کنترل اسکریپت با دو بلندگو، بهبود یافتهاند. این شرکت جزئیات فنی بیشتری در مورد روش مقایسه ارائه نکرده است.
در ارزیابیهای انسانی ناشناس در Voice Arena، گوگل میگوید که مدلهای Flash و Flash-Lite TTS در چندین زبان مهم دنیا به جایگاه بالایی در میان رقبا دست یافتهاند. زبان هایی که گوگل ذکر کرده است عبارتند از ژاپنی، پرتغالی برزیلی، ویتنامی، عربی استاندارد مدرن، اسپانیایی مکزیکی و هندی.
بیشتر بخوانید: مدل جدید گفتار به متن xAI معرفی شد
ایمنی، رضایت و شفافیت در تولید صدا
گوگل بخشی از معرفی این دو مدل را به مکانیزم های ایمنی اختصاص داده است. این شرکت میگوید قابلیتهای ایجاد و تکثیر صدا با مجموعهای از اقدامات حفاظتی برای محافظت از صاحبان صدا، احترام به هویت افراد و ایجاد شفافیت بیشتر در مورد محتوای تولید شده توسط هوش مصنوعی همراه است.
در مورد تقلید صدا، گوگل می گوید از مکانیزم تایید رضایت استفاده می کند. با توجه به توضیحات شرکت، کاربر باید فایل صوتی حاوی رضایت صاحب صدا را ارائه دهد و این فایل باید با صدای نمونه مرجع مطابقت داشته باشد. فقط در این صورت است که می توان یک نسخه شبیه سازی شده از آن صدا ساخت.
گوگل همچنین اعلام کرده است که تمامی فایل های صوتی تولید شده با مدل های Gemini Audio با SynthID واترمارک خواهند شد. به گفته این شرکت، این واترمارک نامحسوس مستقیماً در خروجی صدا قرار می گیرد و به شناسایی محتوای تولید شده توسط هوش مصنوعی کمک می کند. گوگل هدف از این کار را کاهش خطر انتشار اطلاعات نادرست اعلام کرده است.
علاوه بر این موارد، گوگل به استفاده از اعتبار C2PA نیز اشاره کرده است. این شرکت می گوید چنین ابزارهایی برای محافظت از توسعه دهندگان و استعدادهای صوتی در نظر گرفته شده است.
زمان انتشار و دسترسی به پلتفرم ها
گوگل اعلام کرده است که هر دو مدل جدید از امروز عرضه شده اند. بر این اساس، Gemini 3.8 Flash TTS از طریق Gemini API و Google AI Studio در دسترس توسعه دهندگان قرار گرفته است. این شرکت گفته است که دسترسی سازمانی به این مدل به زودی از طریق یک API در Gemini Enterprise فراهم می شود و کاربران عمومی نیز می توانند از آن در Gemini Notebook استفاده کنند.
برنامه مشابهی برای Gemini 3.8 Flash-Lite TTS اعلام شده است. گوگل می گوید این مدل از طریق Gemini API و Google AI Studio در دسترس توسعه دهندگان قرار خواهد گرفت، دسترسی سازمانی بعداً از طریق Gemini Enterprise انجام خواهد شد و کاربران عمومی می توانند از آن در Google Vids استفاده کنند.
در همان زمان، گوگل یک محیط آزمایشی جدید را در استودیوی هوش مصنوعی گوگل معرفی کرده است که آن را به یک فضای کاری طراحی صدا تشبیه کرده است. این شرکت میگوید در این محیط، توسعهدهندگان میتوانند صداهای جدید را از ابتدا ایجاد کنند یا صدای خود را شبیهسازی کنند و سپس آنها را به ویرایشگر اسکریپت دو بلندگو وارد کنند.
علاوه بر این، گوگل لیستی از شرکت ها و پلتفرم های شریک را ذکر کرده است. به گفته این شرکت، پلتفرم هایی مانند Agora، LiveKit، Pipecat و Vercel از Gemini API برای ساخت و استقرار تجربیات تولید گفتار استفاده می کنند. گوگل همچنین گفت که شرکت هایی مانند Figma، HeyGen، Linguana، Wondercraft، 99.co و Ollang در حال ادغام مدل های جدید هستند.
در مجموع، معرفی Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS نشان میدهد که گوگل میخواهد حضور قویتری در بازار ابزارهای صوتی هوش مصنوعی در بازار جهانی فناوری صوتی امروز داشته باشد. این شرکت در معرفی این دو مدل، هم بر آزادی عمل در طراحی صدا و کارگردانی دیالوگ ها و هم بر مقیاس پذیری، پوشش زبان و مکانیسم های ایمنی تاکید کرد. در صورت تحقق این وعده ها، خانواده جمینی آدیو می توانند نقش مهم تری در دوبله، گویندگی دیجیتال، تولید محتوای صوتی و توسعه عامل صوتی داشته باشند.
بیشتر بخوانید: 10 افزونه تبدیل متن به گفتار در مرورگرها



گفتگو در مورد این post