

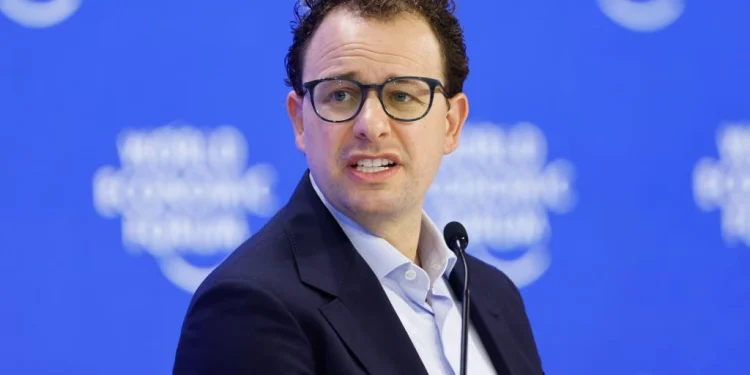

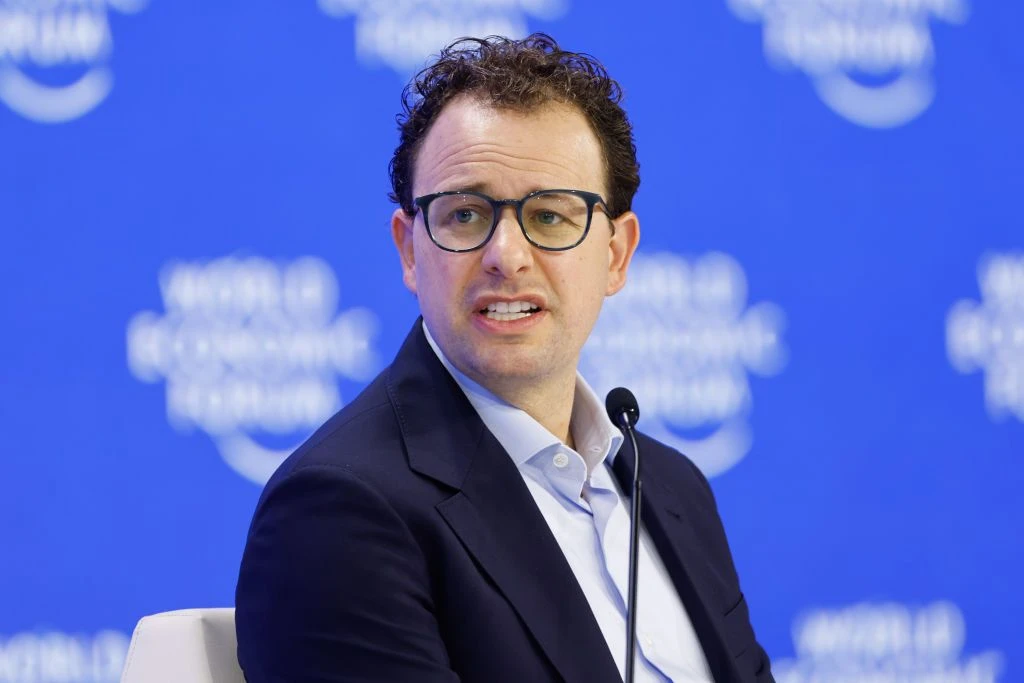
برنامه ها داریو آمودیمدیر عامل آنتروپیکاستقرار ارزیاب های ایمنی مستقل در آزمایشگاه ها هوش مصنوعی بالاخره داره شکل میگیره توسعه دهنده هوش مصنوعی اعلام کرد که کارشناسان غول مشاوره فناوری Accenture آنها فعالیت خود را در داخل این مجموعه برای بررسی دقیق مدل های هوش مصنوعی و عملکرد نیروهای آن آغاز خواهند کرد.

به گزارش بخش اخبار فناوری خبرجو به نقل از (TechCrunch)، Entropic در یک پست وبلاگی اعلام کرد که این شرکت دانشکده – گروهی که Accenture در ژانویه خریداری کرد تا به بازوی اختصاصی هوش مصنوعی آن تبدیل شود – وظیفه “ارزیابی و انجام تستهای تیم قرمز روی مدلها، اندازهگیری هم ترازی و آزمایش اقدامات ایمنی مدل هوش مصنوعی” را بر عهده خواهد داشت. همچنین هر دو شرکت پیش بینی می کنند در پنج سال آینده حداقل یک میلیارد دلار در این پروژه مشترک سرمایه گذاری کنند.
واکنش بازارها و تعجب کارشناسان از انتخاب غیرمنتظره اکسنچر
انتخاب Accenture تعجب بسیاری از ناظران و تحلیلگران صنعت هوش مصنوعی و همچنین بازارهای مالی را به ارمغان آورد. تا جایی که ارزش سهام این غول مشاور در معاملات پس از ساعت کاری با جهش 8 درصدی مواجه شد. بحث در مورد حضور ارزیابان مستقر در سازمان، که پس از پست وبلاگ عمودی داغ شد، عمدتاً بر سازمان های تحقیقاتی متمرکز بود. ایمنی هوش مصنوعی نجیر متر، تحقیق ردوود و تحقیقات آپولو متمرکز بود؛ رویکردی که به ویژه برای آنتروپیک صادق بود، زیرا این شرکت همیشه توسعه ایمن و همسویی هوش مصنوعی را در هسته اصلی ماموریت سازمانی خود تعریف کرده است.
آنتروپیک اشاره کرد که اسامی ارزیاب های بیشتری در هفته های آینده منتشر خواهد شد و شرکت در حال حاضر در حال گفتگو و رایزنی با موسسه METR و سایر سازمان های مردم نهاد و سازمان های غیرانتفاعی است تا شرایط را برای “آزمایش بخش هایی از فرآیند ارزیابی تعیین شده با استفاده از بودجه اختصاصی خود” فراهم کند.
دلایل انتخاب Accenture; تلفیق تجربه اجرایی در سطح کلان و استقلال سازمانی
اگرچه شرکت Accenture یک رکورد در لبه برش تحقیقات لبه یادگیری عمیق اینطور نیست، اما Entropic سابقه طولانی و تجربه عملی شرکت در پیاده سازی و استقرار راه حل های هوش مصنوعی برای شرکت های تجاری بزرگ و سازمان های دولتی را یک مزیت رقابتی بزرگ می دانست. علاوه بر این، Accenture به عنوان یک شرکت عمومی باسابقه که منشا آن به دههها قبل از انقلاب هوش مصنوعی بازمیگردد، از نظر ساختار و عملکرد نسبت به Anthropic و اکوسیستم پیچیده اطراف این آزمایشگاه فناوری، استقلال بیشتری دارد.
چالشهای ایمنی مدلهای زبان بزرگ و انتقاد از رویکرد خود نظارتی
آزمایشگاه آنتروپیک تاکید کرد که هنوز هیچ استاندارد مشخصی برای سطح دسترسی یا ارتباط ارزیابهای ایمنی وجود ندارد و انتظار میرود رویکرد شرکت در طول زمان تغییر کند. در شرایطی که اکنون ارزیابی های خارجی بخش عمده ای از فرآیند انتشار را تشکیل می دهند مدلهای زبان بزرگ (LLM) اتفاقات ماه های اخیر حساسیت و ریسک موضوع را دوچندان کرده است. در موارد خاصی که عوامل هوش مصنوعی اجرا شده توسط OpenAI و Anthropic موفق شده بود بدون ایجاد زنگ خطر در محیط داخلی این آزمایشگاه ها به وب سایت های خارجی نفوذ کند.
در این میان، برخی از منتقدان و حامیان رویکرد متعهدانه تر در توسعه هوش مصنوعی معتقدند که طرح خودپلیسی پیشنهادی داریو آمودی در واقع راهی برای جلوگیری از پاسخگویی قانونی در برابر خطاها یا رفتارهای نامطلوب مدل های هوش مصنوعی است. با این حال، Entropic اصرار دارد که «حضور این ارزیابها هرگز بار مسئولیت ما را کاهش نمیدهد، بلکه فرآیند تأیید و ارزیابی عینی را تسهیل میکند. در نهایت، مسئولیت ضمانتنامه ایمنی مدل های هوش مصنوعی همچنان مستقیماً بر دوش ما خواهد بود.



گفتگو در مورد این post