

معیار Vulsar AI با بررسی ۲۴ مدل زبانی و ۴۷۵ Prompt نشان داد که مدل های پیشرفته بهتر از نویسندگان آماتور عمل می کنند، اما نه از حرفه ای ها.
به گزارش سرویس هوش مصنوعی مجردبا گسترش هوش مصنوعی، گزارشهای مختلفی در مورد امکان جایگزینی مشاغل مرتبط با نوشتن با مدلهای پیشرفتهتر هوش مصنوعی منتشر شده است.
با این حال، نتایج این معیار، بر اساس 475 درخواست، نشان میدهد که تنها مدلهای پیشرفته هوش مصنوعی توانستهاند عملکرد بهتری از نویسندگان انسانی داشته باشند و آن نویسندگان آماتور هستند، نه حرفهایها.
GPT-6 Astra در صدر جدول عملکرد کلی قرار گرفت
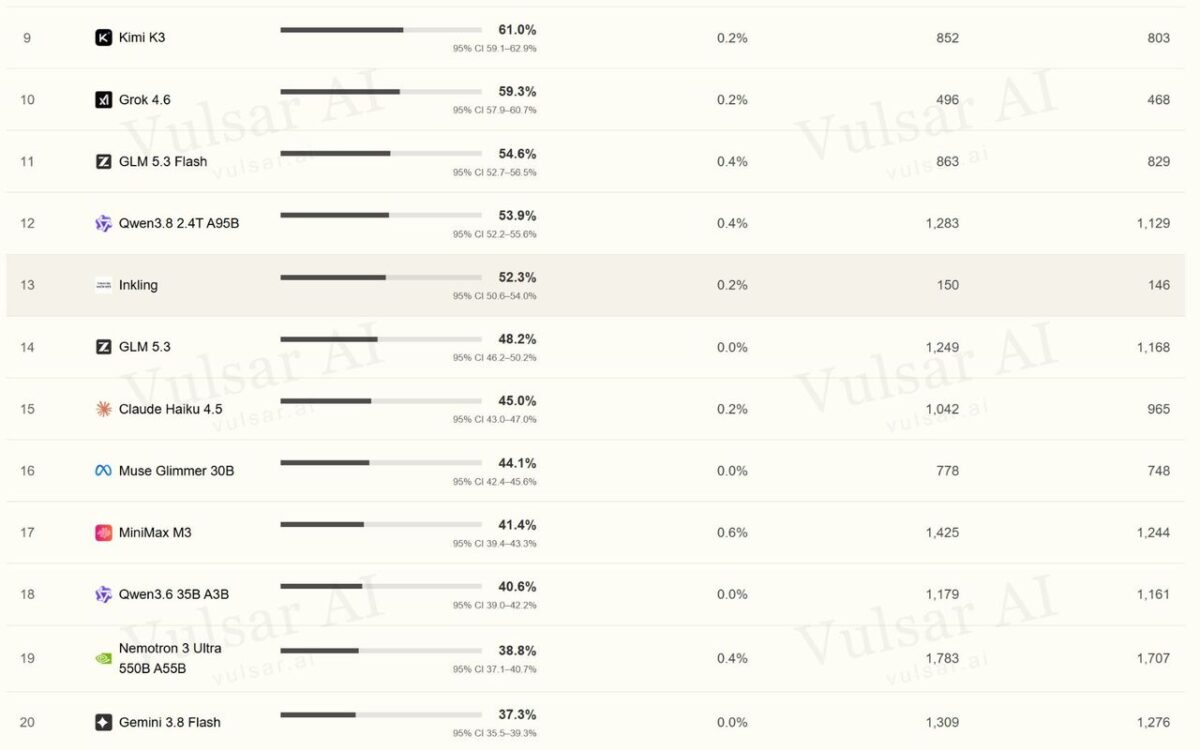
معیار هوش مصنوعی Vulsar نقش مدل های زبان بزرگ را در تولید متون طولانی ارزیابی می کند. در این آزمون، از یک مدل پاداش استفاده میشود که با دادههای ترجیحات انسانی بهخوبی تنظیم میشود تا اولویت کلی خوانندگان را پیشبینی کند.
بر اساس جداول رتبه بندی در تصاویر گزارش، GPT-6 آسترا با نرخ برد پیش بینی شده 87.8 درصد، اندکی جلوتر از نویسندگان انسانی با نرخ برد 86.6 درصد، در صدر قرار گرفت.
با این حال، شکاف مهارتی بین نویسندگان آماتور و حرفه ای بسیار زیاد است.
نتایج آزمایش نشان میدهد که مدلهای پیشرفتهای مانند GPT-6 Astra توانستند از نویسندگان آماتور پیشی بگیرند، اما نویسندگان حرفهای همچنان در یک ارزیابی جداگانه امتیاز بیشتری کسب کردند.
در جایگاه سوم، مدل GPT-5.6 Sol OpenAI با نرخ برد پیش بینی شده 77.6 درصد قرار گرفته است. مدل Claude Fable 5.1 آنتروپیک نیز به نرخ برد 70.3 درصدی رسیده است.
با این حال، پس از بررسی مدل های هوش مصنوعی با تریلیون ها پارامتر، نمرات به طور چشمگیری کاهش می یابد.
به عنوان مثال، مدل هایی مانند Claude Opus 5، Kimi K3 و Grok 4.6 در محدوده 50-65٪ قرار دارند.
این نتایج نشان می دهد که حتی مدل های محبوب هوش مصنوعی نیز با محدودیت هایی مواجه هستند و عملکرد آنها در مقایسه با استانداردهای انسانی یکسان نیست.
مدل های کوچکتر و کم تراکم نتایج ضعیف تری ثبت کرده اند. مدل Qwen3.8-27B به امتیاز 23.2% و DeepSeek V4.1 Flash نیز امتیاز 19.8% را کسب کرده است.
مدل Gemma 4 26B تنها با 10.9 درصد در انتهای جدول قرار دارد.
بیشتر بخوانید: یک جایگزین رایگان و آفلاین برای فتوشاپ با GPT-6 Astra ایجاد شد
نویسندگان انسانی در تولید متن و حفظ انسجام برتری دارند
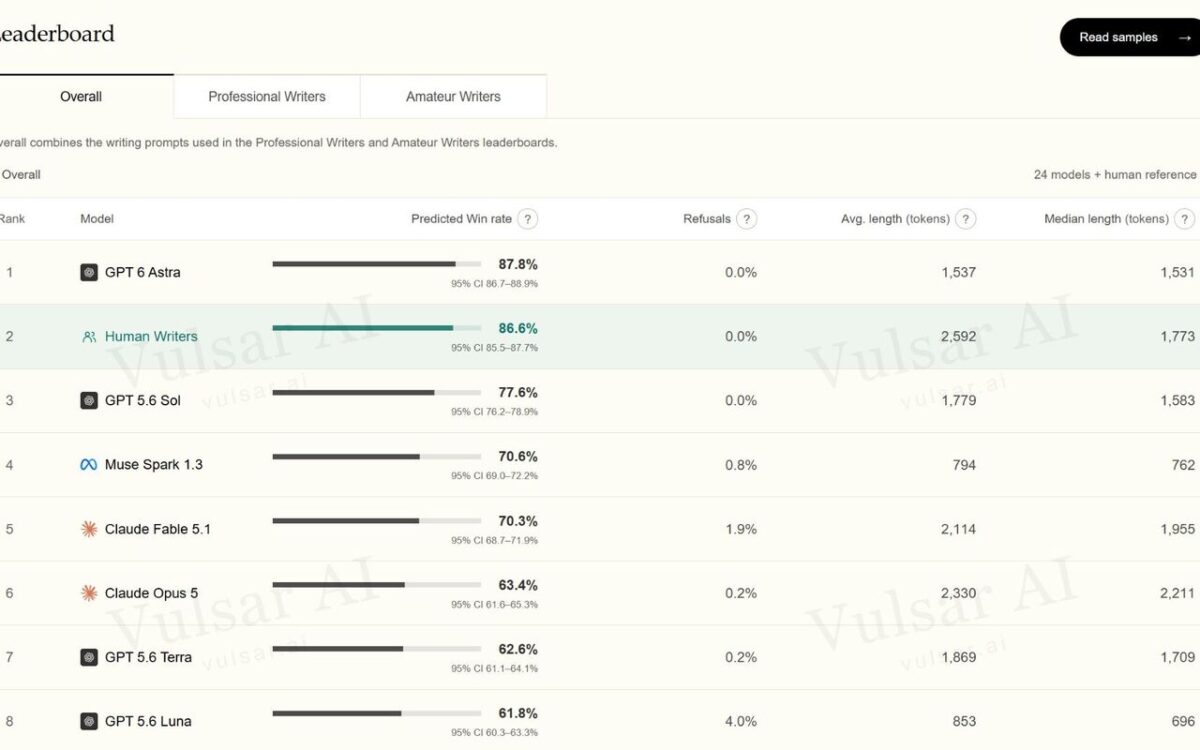
از نظر تعداد توکنهای تولید شده، نویسندههای انسانی بالاترین خروجی را با میانگین 2592 توکن در هر درخواست ثبت کردند.
پس از آن مدل هایی مانند Claude Fable 5.1 با 2114 توکن و GPT-6 Astra با 1537 توکن وجود دارد.
بحث های کاربران در Reddit همچنین به یکی از محدودیت های اصلی مدل های کوچکتر اشاره می کند.
این مدلها وقتی با درخواستهایی مواجه میشوند که چندین فصل را در بر میگیرند، اغلب انسجام روایت را از دست میدهند و عبارات تکراری تولید میکنند.
به همین دلیل هنوز هم نویسندگان انسانی در این زمینه برتر محسوب می شوند.
نویسندگان انسانی نه تنها می توانند داستان های پیچیده را به طور منسجم تری توسعه دهند، بلکه می توانند سبک و سرعت نوشتن خود را با تکیه بر تفکر خودانگیخته تغییر دهند.
با این حال، این سوال باقی میماند که چقدر طول میکشد تا مدلهای زبان بزرگ تقریباً همان کیفیتی را تولید کنند که نویسندگان حرفهای تولید میکنند. بررسی این موضوع نیاز به بحث جداگانه ای دارد.
بیشتر بخوانید: تقاضای بالا برای Astra؛ OpenAI اشتراک 200 دلاری Pro را متوقف کرده است





گفتگو در مورد این post