

Thinking Machines Lab از Inkling 2 Mini، یک مدل هوش مصنوعی منبع باز با وزن های قابل دسترس رونمایی کرد.
بر اساس این گزارش سرویس هوش مصنوعی یک مرحله ایاین مدل تنها با 26 میلیارد پارامتر عملکرد قابل توجهی را در زمینه هایی مانند: برنامه نویسی، استدلال و اجرای وظایف عامل محور ارائه می دهد. مهمتر از همه، این مدل می تواند کاملاً آفلاین بر روی سخت افزارهای مصرف کننده، از جمله مک بوک های اپل مجهز به حافظه یکپارچه 32 گیگابایتی اجرا شود.
مطالب مرتبط: مدل هوش مصنوعی اینکلینگ وارد شد
Inkling 2 Mini که در 20 نوامبر معرفی شد، جایگزین بسیار کوچکتری برای Inkling 2 Small عظیم با 594 میلیارد پارامتر است. Thinking Machines Inc به جای کوچک کردن معماری مدل قبلی، رویکرد متفاوتی را در طراحی خود اتخاذ کرده است که امکان محاسبات استدلالی بیشتری را بدون افزایش تعداد توکنهای تولید شده فراهم میکند. نتایج اولیه این رویکرد امیدوارکننده به نظر می رسد. مدل Inkling 2 Mini در شاخص هوش مصنوعی 20.1 امتیاز کسب کرده است و در مقایسه با مدلهای هوش مصنوعی بزرگتر رقابتی به نظر میرسد.
معماری ترانسفورماتور حلقه ای
طبق توضیحات فنی رسمی Thinking Machines، Inkling 2 Mini از معماری ترانسفورماتور 24 لایه ترکیبی از متخصصان (MoE) استفاده می کند. این مدل در مجموع 26.4 میلیارد پارامتر دارد که تنها 3.4 میلیارد آن به طور فعال استفاده می شود.
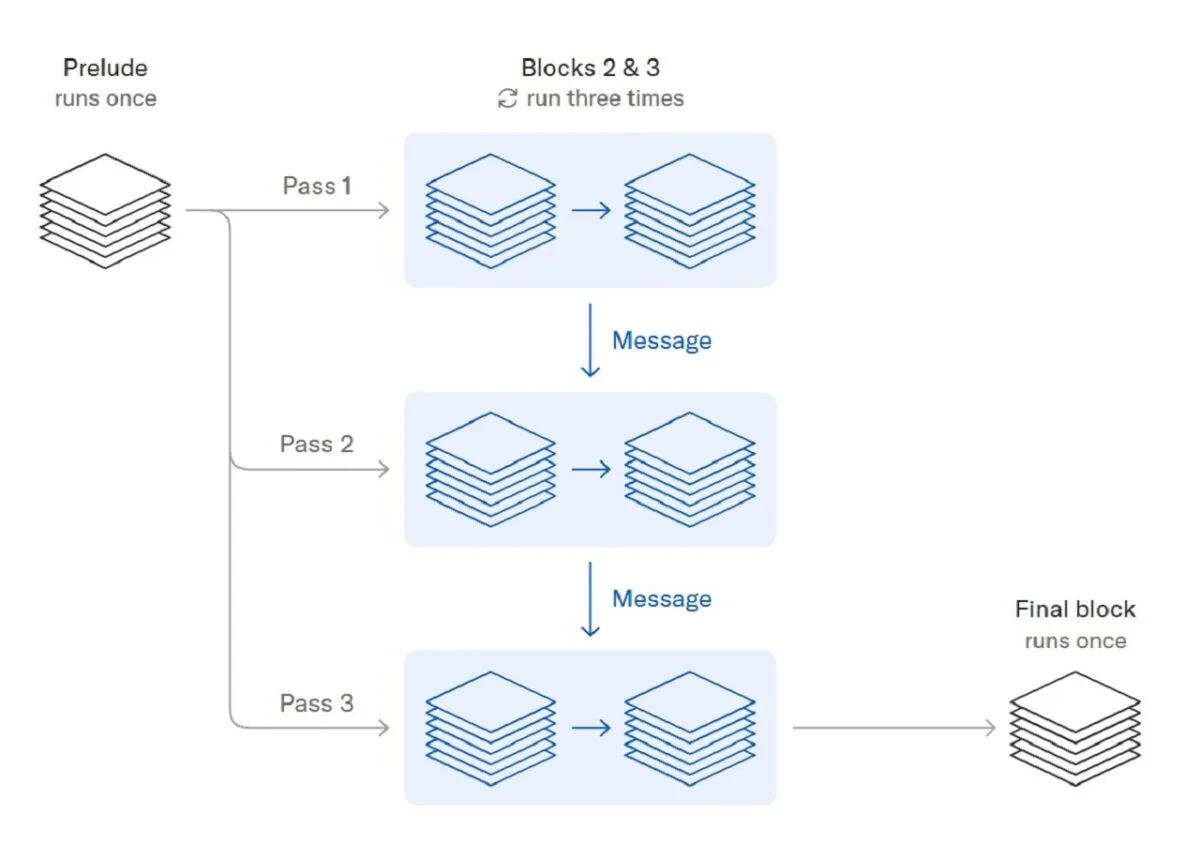
ویژگی متمایز این معماری به نحوه پردازش اطلاعات مربوط می شود. در معماریهای ترانسفورماتور معمولی، هر توکن معمولاً تنها یک بار از هر لایه عبور میکند، اما Inkling 2 Mini سه بار از دوازده لایه میانی خود عبور میکند، در حالی که شش لایه بالا و شش لایه پایین بدون تکرار عمل میکنند. به این ترتیب، هر توکن در مجموع 48 بار توسط لایههای مدل پردازش میشود، حتی اگر وزنهای مدل فقط برای 24 لایه ذخیره میشوند.
این روش تعداد موثر پارامترهای فعال در هر توکن را به 5.4 میلیارد افزایش میدهد و امکان تخصیص محاسبات بیشتری را بدون افزایش متناسب در نیاز حافظه فراهم میکند. به عبارت ساده تر، مدل Inkling 2 Mini می تواند محاسبات بیشتری را در فرآیند استدلال داخلی خود قبل از تولید توکن بعدی انجام دهد.
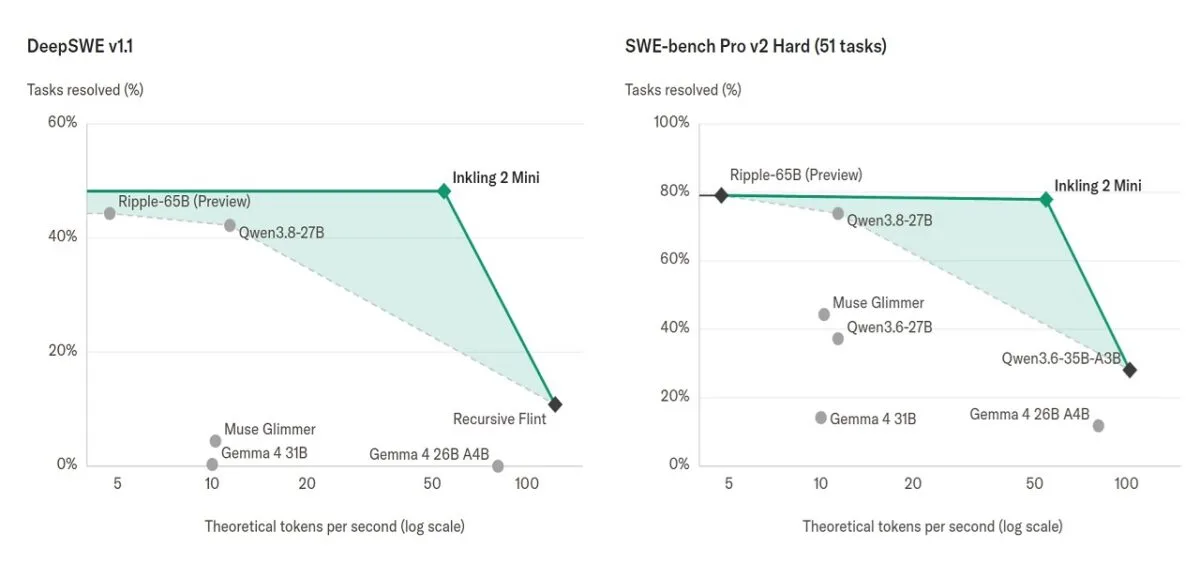
Thinking Machines ادعا می کند که این رویکرد پیشرفت های قابل توجهی را به خصوص در برنامه نویسی عامل محور ایجاد می کند. مدل Inkling 2 Mini امتیاز 48.2% را در بنچمارک DeepSWE v1.1 کسب کرده است. در حالی که مدل Qwen3.8-27B امتیاز 42.2% را به ثبت رساند. همچنین
این مدل در نسخه سخت تست SWE-bench Pro v2 Hard امتیاز 77.9% را کسب کرد و از نتیجه 73.8% رقیب خود پیشی گرفت. Inkling 2 Mini 46.5% در Vals Index v2.2 و 79.2% در SWE-bench Verified امتیاز کسب کرده است. البته این ارقام نتایج ارزیابی های منتشر شده توسط سازنده است و به دلیل تفاوت در پیکربندی و شرایط تست ها نباید به عنوان برتری عملکرد قطعی در تمامی کاربردها تعبیر شود.
حتما بخوانید: اجرای نسخه انحصاری ChatGPT بر روی کنسول 35 ساله نینتندو
نکته قابل توجه دیگر این است که Thinking Machines از پلتفرم پردازشی GB300 Grace Blackwell Ultra انویدیا برای آموزش Inkling 2 Mini استفاده می کند. این شرکت با بهره گیری از قابلیت های NVFP4 که از طریق شتاب سخت افزاری پیاده سازی می شوند، کارایی فرآیند آموزش مدل را بهبود بخشیده است.
اکثر وزنه های مدل با NVFP4 دقیق عددی 4 بیتی آموزش داده می شوند. در حالی که چهار لایه آخر از دقت 8 بیتی MXFP8 استفاده می کنند. از آنجایی که وزنهای مدل در حین استقرار با همان دقت عددی مورد استفاده در مرحله آموزش استفاده میشوند، طبق گفته ماشینهای فکری، مدل از افت دقت ناشی از تبدیلهای اضافی در فرآیند کوانتیزاسیون پس از آموزش جلوگیری میکند.
مدل Inkling 2 Mini به صورت آفلاین اجرا می شود
شاید مهم ترین ویژگی Inkling 2 Mini دسترسی بالای آن باشد. این مدل با وجود داشتن ویژگی های پیشرفته، تنها حدود 20 گیگابایت حافظه مصرف می کند و می توان آن را بر روی رایانه های مک مجهز به تراشه های سیلیکون اپل و حداقل 32 گیگابایت حافظه یکپارچه از طریق ابزار Olama اجرا کرد. کامپیوتر رومیزی هوش مصنوعی NVIDIA DGX Spark نیز به طور رسمی از این مدل پشتیبانی می کند. علاوه بر این، امکان اجرای آن بر روی سایر تنظیمات مجهز به پردازنده گرافیکی نیز وجود دارد. با این حال، استفاده از حداقل 32 گیگابایت حافظه ویدیویی (VRAM) یا بیشتر توصیه می شود. مدل Inkling 2 Mini از ورودی متن و تصویر پشتیبانی می کند و پنجره زمینه آن ظرفیت پردازش تا یک میلیون توکن را دارد.
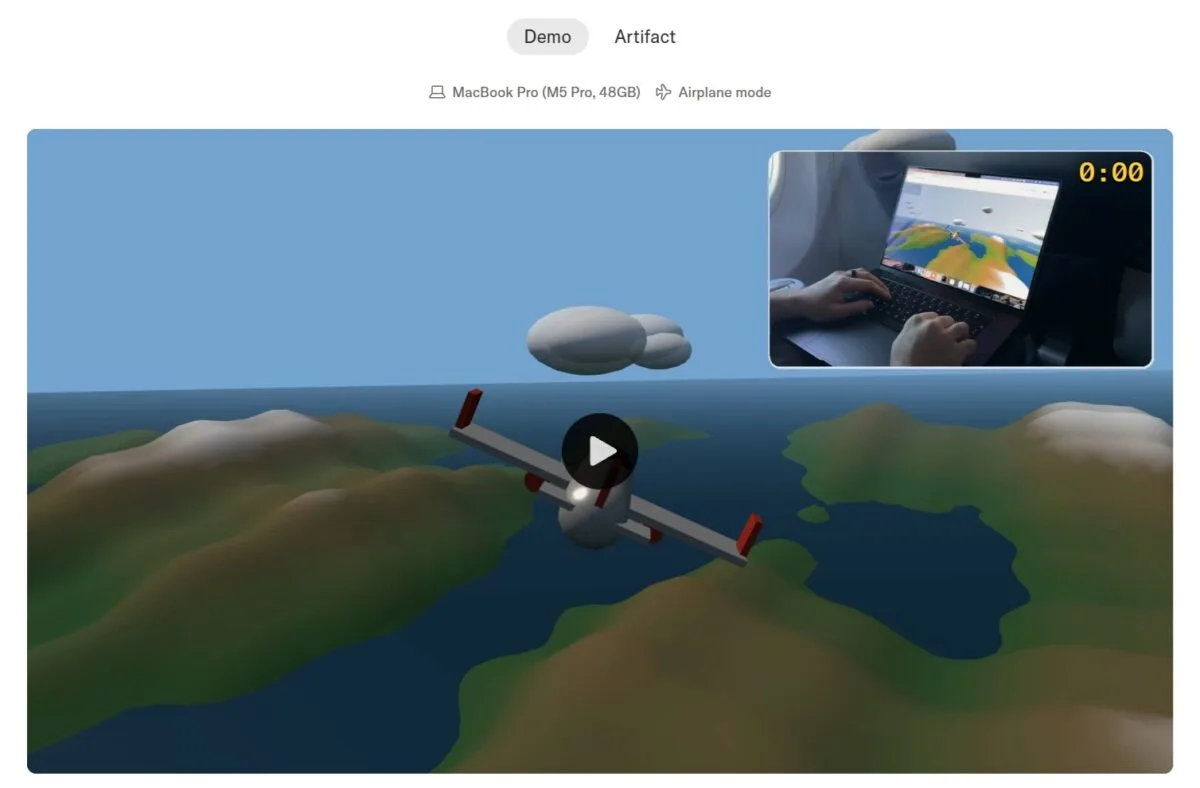
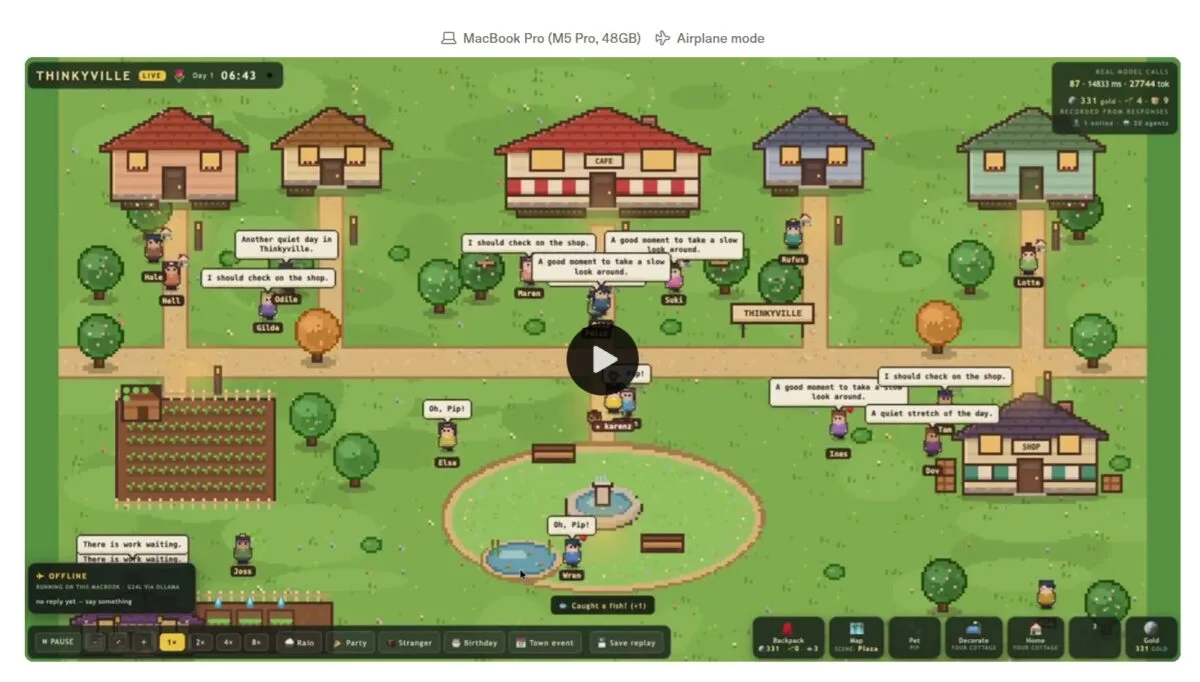
Thinking Machines برای نشان دادن قابلیت های مدل جدید خود، اجرای کاملا آفلاین خود را روی مک بوک پرو مجهز به تراشه M5 Pro و 48 گیگابایت حافظه به نمایش گذاشت. به گفته این شرکت، Inkling 2 Mini توانست در طی یک پرواز تنها در چند دقیقه یک شبیه ساز پرواز تعاملی و قابل بازی تولید کند.
با وجود این، معماری این مدل سوالات مهمی در مورد ایمنی و شفافیت سیستم های هوش مصنوعی ایجاد می کند. از آنجا که ترانسفورماتورهای حلقه می توانند محاسبات اضافی را بدون نوشتن تمام مراحل استدلال انجام دهند، برخی از محققان این نگرانی را مطرح کرده اند که نظارت و نظارت بر رفتار چنین مدل هایی دشوارتر می شود.
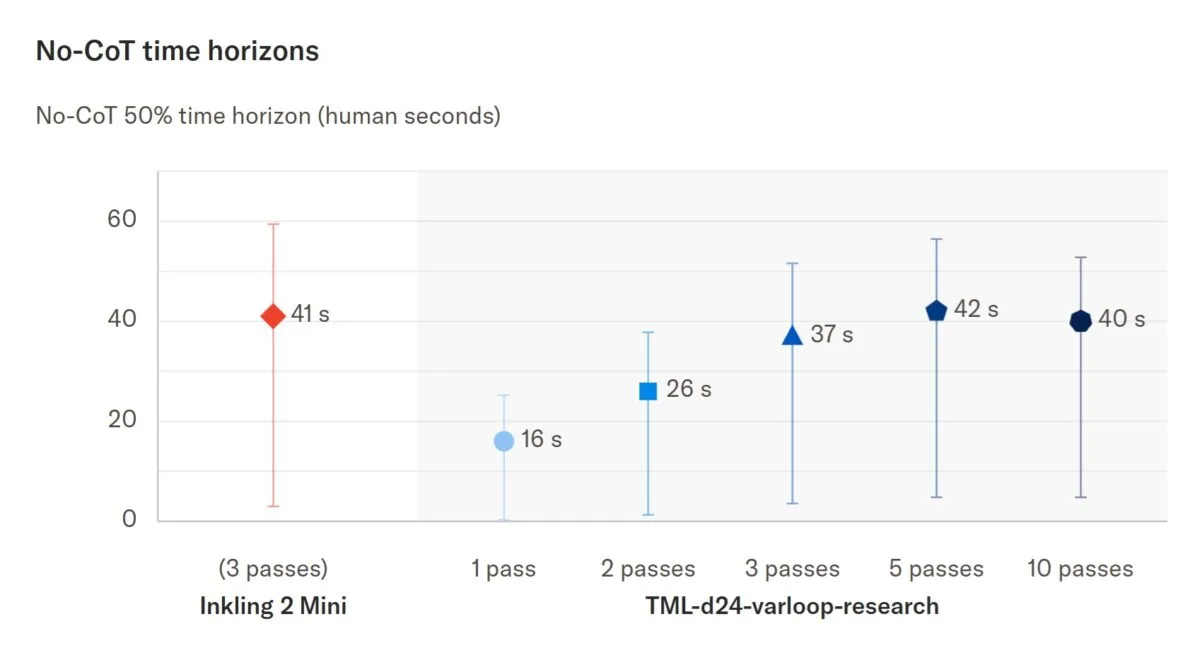
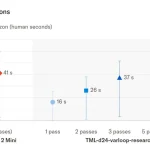
برای بررسی این موضوع، Thinking Machines آزمایش هایی را با استفاده از یک مدل تحقیقاتی مستقل با قابلیت تغییر تعداد حلقه های پردازش انجام داد. نتایج نشان داد که افزایش تعداد پاسهای پردازشی، توانایی مدل را در حل مسائل بدون تولید زنجیرهای از استدلال نوشتاری افزایش میدهد. مدت زمان افق حل مسئله بدون زنجیره استدلال صریح نیز از 16 ثانیه با یک پاس پردازش به 37 ثانیه با سه پاس افزایش یافت.
با وجود این، آزمایشات این شرکت نشان داد که فرآیند استدلال کتبی مدل قابل درک است و در این مقیاس، افت قابل توجهی در قابلیت نظارت آن مشاهده نمی شود. در عین حال، محققان محدودیت های مدل را پذیرفته اند. از جمله عملکرد ضعیفتر در مکالمات پیچیده چند مرحلهای و پیروی از دستورالعملهایی که حاوی محدودیتها و شرایط متعدد هستند.
بیشتر بخوانید: توهین به چت بات ها احتمال دریافت پاسخ بهتر را کاهش می دهد
Inkling 2 Mini اکنون تحت مجوز Apache 2.0 منتشر شده است. وزنههای قابل دانلود آن از طریق پلتفرم Hugging Face در دسترس هستند و کاربران میتوانند آن را به صورت محلی با استفاده از Olama مستقر کنند. همچنین امکان استنتاج و تنظیم دقیق مدل از طریق پلتفرم Tinker متعلق به Thinking Machines وجود دارد. برای توسعه دهندگانی که به دنبال اجرای عوامل هوش مصنوعی پیشرفته بر روی سخت افزار خود و کاهش وابستگی به زیرساخت های رایانش ابری هستند، Inkling 2 Mini نمونه دیگری از تلاش ها برای در دسترس تر کردن مدل های پیشرفته هوش مصنوعی است.


گفتگو در مورد این post