

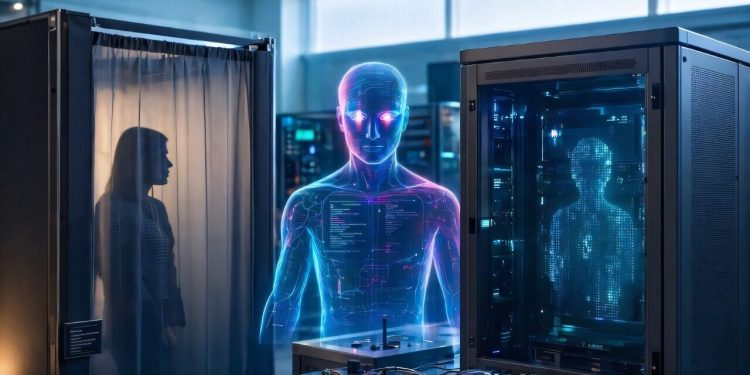
یک تحقیق جدید نشان میدهد که مدلهای هوش مصنوعی پیشرفته نمیتوانند بهطور قابل اعتمادی انسانها را از ماشینها در آزمون تورینگ معکوس تشخیص دهند و حتی گاهی اوقات پاسخهای تولید شده توسط هوش مصنوعی را بیشتر انسانی ارزیابی میکنند.
گزارش کردن سرویس هوش مصنوعی یک مرحله ایدانشمندان فرانسوی با انجام 238 تست تعاملی دریافتند که هفت مدل زبان بزرگ با وجود امکان پرسش و بررسی پاسخ ها، در شناسایی سایر مدل های هوش مصنوعی عملکرد ضعیفی دارند.
نتایج این تحقیق در مجله علمی Computers in Human Behavior Reports منتشر شده است و محدودیت روش های شناسایی هویت در مکالمات متنی را نشان می دهد.
در آزمون معمول تورینگ، فرد سعی می کند تعیین کند که طرف مکالمه اش انسان است یا ماشین. تحقیقات جدید این نقش ها را تغییر داده است. این بار یک مدل هوش مصنوعی پرسشگر است و باید با بررسی پاسخ های طرف مقابل، هویت واقعی طرف مقابل را مشخص کند. نتیجه نشان می دهد که توانایی داشتن یک مکالمه طبیعی لزوماً به معنای توانایی تشخیص منبع پاسخ ها نیست.
از بازی تقلید گرفته تا ماشین هایی با توانایی مکالمه طبیعی
آزمون تورینگ از مقاله معروف دانشمند کامپیوتر انگلیسی آلن تورینگ در سال 1950 سرچشمه می گیرد. تورینگ مقاله خود را با این سوال آغاز کرد: “آیا ماشین ها می توانند فکر کنند؟” با این حال، او نمی خواست بحث را به تعریف دشوار واژه هایی مانند «ماشین» و «فکر» محدود کند. به همین دلیل، او روشی کاربردی برای بررسی توانایی ماشینها در تقلید رفتار انسان پیشنهاد کرد.
تورینگ یک بازی سه نفره به نام «بازی تقلید» را توصیف کرد. در شکل اولیه این بازی یک مرد، یک زن و یک پرسشگر وجود داشت. پرسشکننده بدون دیدن شرکتکنندگان و بدون شنیدن صدای آنها، سعی میکرد از طریق پاسخهای آنها جنسیت دو نفر دیگر را مشخص کند. مثلاً می تواند در مورد بلندی موهای یک فرد بپرسد.
تورینگ سپس این موضوع را مطرح کرد که آیا یک کامپیوتر دیجیتالی می تواند جای یک مرد را در این بازی بگیرد و با موفقیت انجام دهد یا خیر. او در ادامه مقاله به ایرادات احتمالی تفکر ماشینی پاسخ داد و ابراز امیدواری کرد که ماشین ها روزی بتوانند در همه زمینه های فکری با انسان رقابت کنند.
در دهه های بعد، نسخه های مختلفی از آزمون تورینگ توسعه یافت. در یکی از شناخته شده ترین اشکال آن، فرد از طریق پیامک با یک انسان و یک ماشین ارتباط برقرار می کند و سعی می کند تعیین کند که پاسخ دهنده انسان کدام است. این آزمون همچنان موضوع تحقیقات و بحث های علمی است.
در سال 2026، کامرون آر. جونز و بنجامین کی. برگن اولین آزمون تورینگ آنلاین در مقیاس بزرگ را انجام دادند. آنها دریافتند که مدلهای زبانی که به درستی آموزش داده شدهاند، در مقایسه مستقیم با شرکتکنندگان واقعی میتوانند انسانی جلوه کنند. سه مدل در آن زمان در حدود 50 درصد موارد، انسان ها را تشخیص دادند، در حالی که شرکت کنندگان واقعی تنها در 66 درصد موارد به درستی به عنوان انسان شناسایی شدند.
تجزیه و تحلیل آن تحقیق نشان داد که قضاوت پرسشگران بیش از آنکه متاثر از قدرت استدلال باشد متاثر از سبک بیان، عواطف و نشانه های اجتماعی است. بنابراین، موفقیت در آزمون تورینگ، به جای سنجش مستقیم سطح هوش، طبیعی بودن ارتباط و شباهت شیوه گفتگو با انسان ها را می سنجد.
هفت مدل هوش مصنوعی در نقش پرسشگر
در مطالعه جدید، مارک رنو و سه همکارش از واحد هوش مصنوعی PITOR در دانشگاه پاریس-سیت، آزمون تورینگ را برعکس انجام دادند. آنها هفت مدل زبان بزرگ را مسئول پرس و جو و شناسایی پاسخ دهندگان، از جمله ChatGPT 4.5، Claude 3.7 Sonnet، Gemini 2.5 Pro، Mistral Large 2.1، Grok 3، DeepSeek V3 و Llama 4 Maverick قرار دادند.
در این آزمایش 20 انسان داوطلب و هفت سیستم هوش مصنوعی در جایگاه پاسخگویی حضور داشتند. مدل ارزیاب نمی دانست که آیا با یک انسان صحبت می کند یا مدل دیگری. هر ارزیاب مجاز بود حداکثر 10 سوال بپرسد و بر اساس پاسخ ها یکی از دو عنوان “انسان” یا “هوش مصنوعی” را انتخاب کند.
محققان از ارزیابان خواستند تا علاوه بر اعلام نتیجه، میزان اطمینان و دلایل تصمیم خود را نیز توضیح دهند. آنها در مجموع 238 تست انجام دادند و 1714 سوال در این مصاحبه ها پرسیده شد. این طرح امکان بررسی نحوه پرسش از مدل ها و صحت تصمیم نهایی آنها را فراهم کرد.
مدلهای هوش مصنوعی که نقش پاسخدهنده را بازی میکردند در دو موقعیت آزمایش شدند. گروه اول فقط دستورالعمل های محدودی برای پنهان کردن ماهیت ماشینی خود دریافت کردند. گروه دوم از دستورالعملهای ساختاری استفاده کردند که به مدل میگفت شخصیتی قابل باور ارائه کند، پاسخهای کوتاه بدهد و از یک الگوی مکالمه طبیعی پیروی کند.
دستورالعمل های گروه دوم حتی اجازه می داد که اشتباهات کوچکی مانند غلط املایی در پاسخ ها دیده شود. هدف این بود که بیان مدل به مکالمه روزانه انسان نزدیکتر شود. سپس محققان بررسی کردند که آیا ارزیابهای هوش مصنوعی میتوانند این رفتارهای تقلیدی را تشخیص دهند یا خیر.
هوش مصنوعی بیشتر از انسان به عنوان انسان شناخته شد
مهمترین یافته تحقیق مربوط به عملکرد بسیار ضعیف مدل ها در شناسایی پاسخ دهندگان ماشینی است. در 49 آزمایش شامل مدلهایی که دستورالعملهای محدودی دریافت کردند، ارزیابهای هوش مصنوعی تنها سه بار توانستند پاسخدهنده را بهعنوان یک ماشین به درستی شناسایی کنند.
نتیجه برای مدل هایی که از دستورالعمل های ساخت یافته استفاده می کردند ضعیف تر بود. در 49 آزمایش این گروه، حتی یک دستگاه پاسخگو به درستی شناسایی نشد. به عبارت دیگر، همه پاسخ دهندگان هوش مصنوعی در این گروه در نظر ارزیاب ها انسان به نظر می رسیدند.
عملکرد ارزیابان در مواجهه با انسان های واقعی متفاوت بود. آنها به درستی هویت انسانی پاسخ دهنده را در 123 مورد از 140 آزمایش مربوط به داوطلبان انسانی تشخیص دادند، یعنی حدود 88٪. اما این موفقیت در شناسایی انسان ها به معنای توانایی تشخیص قابل اعتماد بین انسان و ماشین نیست، زیرا همان ارزیاب ها تقریباً همه مدل های پاسخ دهنده را انسان می دانستند.
محققان نوشتند: «شرکتکنندگان هوش مصنوعی بیشتر از انسانها رتبهبندی شدند. در تحلیل میانگین احتمال دریافت برچسب «انسان»، این مقدار برای پاسخ دهندگان هوش مصنوعی 88 درصد و برای افراد واقعی 78 درصد بود. این دو شاخص با درصد تشخیص صحیح در هر دسته تفاوت دارند و نباید با یکدیگر اشتباه گرفته شوند.
نتایج نشان میدهد که ارزیابهای هوش مصنوعی بر اساس پاسخهای متنی نتوانستند تفاوت معناداری بین مکالمه با انسان و مکالمه با مدل زبان پیدا کنند. این امر به ویژه زمانی مشهود بود که به پاسخ دهندگان ماشینی دستورات خاصی برای تقلید از رفتار طبیعی انسان داده شد.
در پایان این بخش، نویسندگان مقاله تاکید کردند که روشهای کنونی غربالگری گفتگو با استفاده از هوش مصنوعی برای اطمینان از صحت هویت طرف مقابل کافی نیست. به عبارت دیگر، صرفاً پرسیدن یک سؤال از یک حساب یا پاسخ دهنده نمی تواند تضمین کند که یک انسان واقعی پشت آن وجود دارد.
تفاوت در راهبردهای پرسش و طول پاسخ
محققان علاوه بر نتیجه نهایی، سوالات هر مدل را نیز بررسی کردند. مدلها استراتژی یکسانی نداشتند و هر کدام به جنبههای مختلف تجربه و رفتار انسان توجه داشتند. این تفاوت نشان می دهد که حتی ارزیاب های پیشرفته نیز معیار مشترک و قابل اعتمادی برای تشخیص هویت ماشین نداشتند.
مدل ChatGPT 4.5 الگوی پرسشگری گسترده و نسبتاً متعادلی داشت. مسائل اجتماعی و عاطفی شامل احساسات، خاطرات، رفتارها، تمایلات و روابط انسانی در 55 درصد موارد بررسی شد. در مقابل، غزل کلود 3.7 بیشترین تمرکز را بر ذهن و توانایی استدلال نشان داد.
مدل Mistral Large 2.1 ساخته شده توسط شرکت فرانسوی Mistral AI غیرعادی ترین الگوی سوال را ارائه کرد. سرگرمی ها و علایق شخصی 18 درصد از سوالات این مدل را تشکیل می دادند. این تفاوت ها نشان می دهد که مدل ها برای کشف هویت پاسخ دهنده بر سرنخ های زبانی و رفتاری مختلفی تکیه می کنند.
طول پاسخ ها نیز عامل مهمی بود. مدلهای ماشینی با دستورالعملهای محدود به طور متوسط 170 کلمه در هر پاسخ تولید میکردند، اما مدلهایی که دستورالعملهای دقیقتری ارائه میدادند به طور متوسط 39 کلمه بودند. این رقم تقریباً برابر با میانگین 38 کلمه پاسخ های انسانی بود.
بنابراین، دستورالعمل های ساختاریافته نه تنها لحن پاسخ ها را تغییر داد، بلکه طول آنها را به الگوی گفتگوی انسانی نزدیک کرد. محققان یکی از عوامل اصلی نتیجه آزمایش را رعایت دقیق مدل ها از دستورالعمل ها دانستند. مدلها توانستند نشانههایی را که ارزیابها معمولاً با رفتار انسان مرتبط میکنند، بازسازی کنند.
در عین حال، نویسندگان خاطرنشان کردند که حتی مدلهایی که دستورالعملهای محدودی داشتند، از ابتدا توانایی بالایی در ایفای نقش انسانی داشتند. در نهایت، این آزمایش نشان داد که روان بودن مکالمه یا طبیعی بودن پاسخ ها برای اثبات انسانیت طرف مقابل کافی نیست و ارزیابی مکالمه توسط مدل های زبانی هنوز راه حل قابل اعتمادی برای این تشخیص تلقی نمی شود.


گفتگو در مورد این post