

در رویداد Adobe Max 2026، ادوبی از چهار ابزار آزمایشی هوش مصنوعی برای تبدیل تصاویر به محیط های سه بعدی، طراحی شخصیت های مجازی و ساده سازی ویرایش صوتی و تصویری رونمایی کرد.
به گزارش سرویس هوش مصنوعی تکناکدر کنفرانس سالانه Adobe Max، این شرکت مجموعهای از فناوریهای جدید را به نمایش گذاشت که میتوانند نحوه تولید محتوای دیجیتال را تغییر دهند. این ابزارها امکان حرکت در محیط تصاویر ثابت، مکالمه با شخصیت های ساخته شده با هوش مصنوعی، تولید تعاملی افکت های صوتی و انتقال خودکار ویرایش ها به قسمت های مختلف تصاویر را فراهم می کنند.
Adobe این فناوری ها را در قالب برنامه تست Sneaks معرفی کرده است. هدف از این برنامه نمایش ویژگی هایی است که هنوز در مرحله تحقیق و توسعه هستند و ممکن است در آینده به محصولات تجاری این شرکت اضافه شوند. چهار پروژه جدید به نامهای Project Screen Test، Project Sight Span، Project Sound Bender و Project Rinse Repeat معرفی شدهاند.
وجه مشترک این پروژه ها استفاده از هوش مصنوعی مولد برای ساده سازی فعالیت هایی است که معمولاً به مهارت و زمان تخصصی نیاز دارند. Adobe سعی می کند ابزارهای پیچیده طراحی، فیلم سازی و ویرایش صدا را به محیط های تعاملی تبدیل کند تا کاربران بتوانند تغییرات مورد نظر خود را با دستورات متنی، مکالمه و حرکات ساده ماوس اعمال کنند.
طراحی شخصیت های مجازی با قابلیت گفتگو و تعیین ویژگی های رفتاری
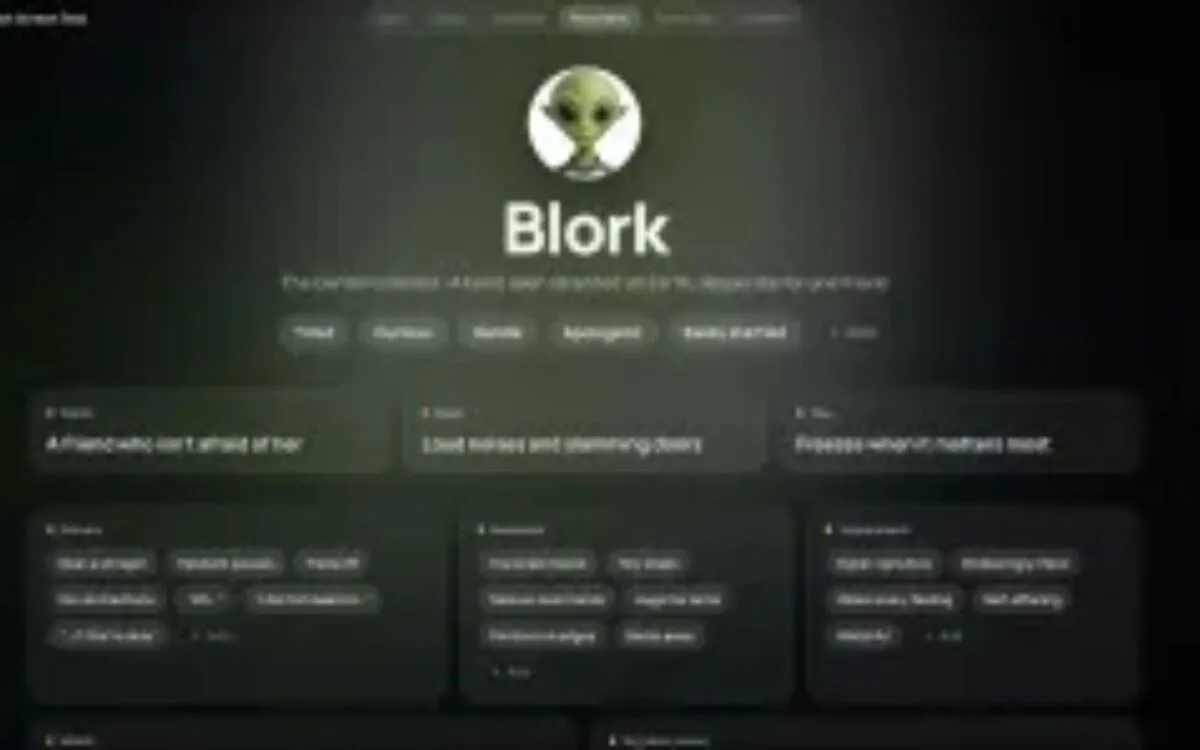
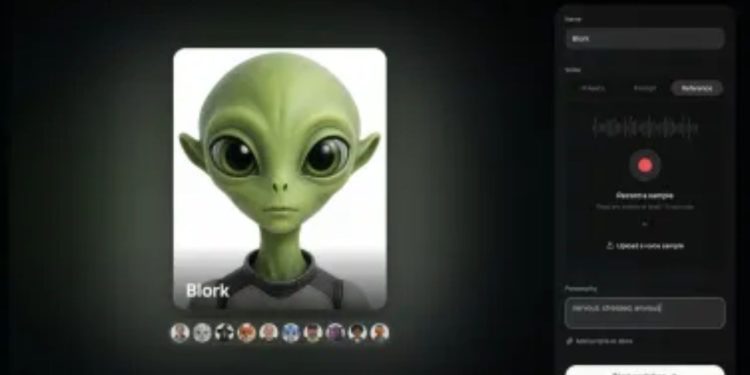
Project Screen Test یکی از متفاوت ترین فناوری هایی است که در رویداد امسال معرفی شده است. این ابزار به تولیدکنندگان محتوا این امکان را می دهد که شخصیت های مجازی را با هوش مصنوعی طراحی کنند و ویژگی های رفتاری آن ها را از طریق گفتگوی مستقیم شکل دهند.
در روش های معمول خلق شخصیت با هوش مصنوعی، کاربران باید ظاهر، صدا و رفتار شخصیت را با دستورات متنی توضیح دهند. با این حال، Screen Test فرآیند متفاوتی را ارائه می دهد و به شما امکان می دهد با شخصیت مجازی گفتگوی مستقیم داشته باشید. این تجربه بسیار شبیه به جلسه استماع است و کاربر می تواند عملکرد شخصیت را در حین صحبت ارزیابی کند.
فرآیند طراحی با تعیین ویژگی های اساسی شخصیت آغاز می شود. به عنوان مثال، کاربران می توانند ویژگی هایی مانند خجالتی بودن، اضطراب یا دست و پا چلفتی را انتخاب کنند. سپس باید صدای شخصیت را مشخص کنند. این مرحله با انتخاب صداهای آماده، توصیف ویژگی های صدا و یا آپلود نمونه صدا انجام می شود.
پس از ایجاد کاراکتر اولیه، کاربران می توانند مانند تماس ویدیویی FaceTime با آن مکالمه داشته باشند. در طول این گفتگو، می توان جزئیات شخصیت از جمله گذشته، خلق و خو، اهداف، ضعف ها، ترس ها و ویژگی های حرکتی را توسعه داد.
به عنوان مثال، کاربر می تواند در مورد وقایع گذشته شخصیت صحبت کند یا از او بخواهد که واکنش خاصی به یک موقعیت نشان دهد. این تعاملات به شکل گیری هویت رفتاری شخصیت کمک می کند و رفتار او را در موقعیت های مختلف هماهنگ می کند.
پس از تکمیل فرآیند طراحی، کاربران می توانند محیط یا سناریوی مورد نظر خود را توصیف کنند. بر اساس این توضیحات، ابزار صحنه های متحرک با حضور شخصیت تولید می کند. بخش Personality همچنین به شما اجازه می دهد تا به صورت دستی ویژگی هایی را که در طول مکالمه ایجاد می شود ویرایش کنید.
نتایج اولیه این فناوری نشان میدهد که شخصیتهای تولید شده میتوانند هویت متمایزتر و رفتار پایدارتری نسبت به بسیاری از شخصیتهای متحرک ایجاد شده با هوش مصنوعی داشته باشند.
این مهم است زیرا ابزارهای فعلی تولید ویدیو با هوش مصنوعی در مقایسه با انیمیشن های سنتی خلاقیت محدودی دارند. در روشهای سنتی، سازندگان میتوانند آگاهانه تمام جزئیات رفتار و شخصیت را طراحی کنند.
Project Screen Test در حال حاضر یک پروژه مستقل است و هنوز مشخص نیست که آیا Adobe آن را به ابزارهای تولید ویدیوی موجود خود اضافه خواهد کرد یا خیر.
بیشتر بخوانید: Adobe با قدرت وارد رقابت هوش مصنوعی مبتنی بر عامل می شود
عکس ها و نقاشی ها را به محیط های سه بعدی قابل کاوش تبدیل کنید
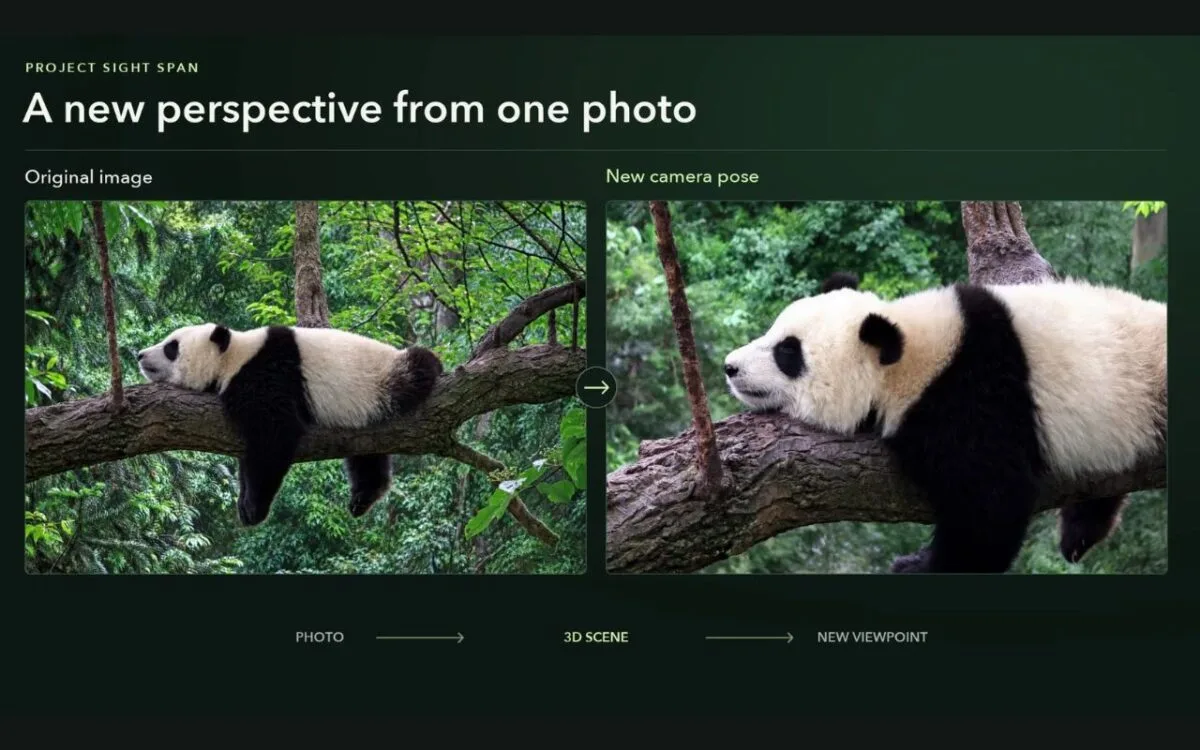
دومین فناوری معرفی شده، Project Sight Span، امکان تبدیل تصاویر دو بعدی به محیط های سه بعدی قابل کاوش را فراهم می کند. کاربران می توانند در فضای تصویر حرکت کنند، زاویه دید را تغییر دهند و قسمت هایی از محیط را ببینند که در قاب اصلی وجود نداشت.
این ابزار با استفاده از هوش مصنوعی، اشیا و پس زمینه های خارج از محدوده تصویر اصلی را بازسازی می کند. عناصر جدید به گونه ای تولید می شوند که با ساختار و فضای تصویر هماهنگ باشند. حتی امکان تغییر زاویه دوربین برای مشاهده قسمت های پشت صحنه وجود دارد.
به عنوان مثال، کاربر می تواند یک تصویر ثابت را در ابزار وارد کند و سپس دوربین مجازی را به سمت راست یا چپ حرکت دهد. Sight Span بخشهای جدیدی از محیط را ایجاد میکند تا کاربر بتواند صحنه را از موقعیتی متفاوت مشاهده کند.
یکی از ویژگی های مهم این فناوری پشتیبانی از انواع تصاویر است. علاوه بر عکسهای واقعی، Project Sight Span میتواند نقشهها و تصاویر گرافیکی را نیز پردازش کند. این ابزار هنگام بازآفرینی محیط سه بعدی، سبک هنری تصویر اصلی را حفظ می کند.
در تصاویر صورت، جزئیاتی مانند خالکوبی و ویژگی های صورت حتی پس از تغییر زاویه دید نیز تا حد زیادی قابل تشخیص هستند. این ویژگی به حفظ ارتباط بین تصویر اصلی و خروجی تولید شده کمک می کند.
البته محیط سه بعدی هنگام حرکت دوربین کیفیت بصری چندان بالایی ندارد. برخی از قسمت ها پیکسلی هستند و جزئیات دقیقی ندارند. با این حال، هنگامی که کاربر زاویه نهایی را انتخاب می کند، ابزار وضوح و کیفیت تصویر را بازیابی می کند.
عملکرد Sight Span تا حدودی شبیه به ویژگی Spatial Reframing اپل است، اما امکانات گسترده تری برای تغییر موقعیت دوربین ارائه می دهد. کاربران می توانند زاویه تصویر را تا حد زیادی تغییر دهند و حتی نقطه عکسبرداری کاملا متفاوتی را انتخاب کنند.
با این حال، استفاده گسترده از این قابلیت مرز بین عکاسی و تولید تصویر با هوش مصنوعی را محو می کند. این به این دلیل است که قطعات خارج از قاب اصلی در واقع توسط دوربین ضبط نشده اند و توسط هوش مصنوعی تولید شده اند.
Adobe قصد دارد عملکرد این فناوری را در بخش پروژه آزمایشی کنفرانس Adobe Max به نمایش بگذارد.
بیشتر بخوانید: Adobe و Google برای اتصال Acrobat به Gemini و Google Drive با یکدیگر همکاری می کنند
تولید جلوه های صوتی با حرکت ماوس در یک محیط تعاملی
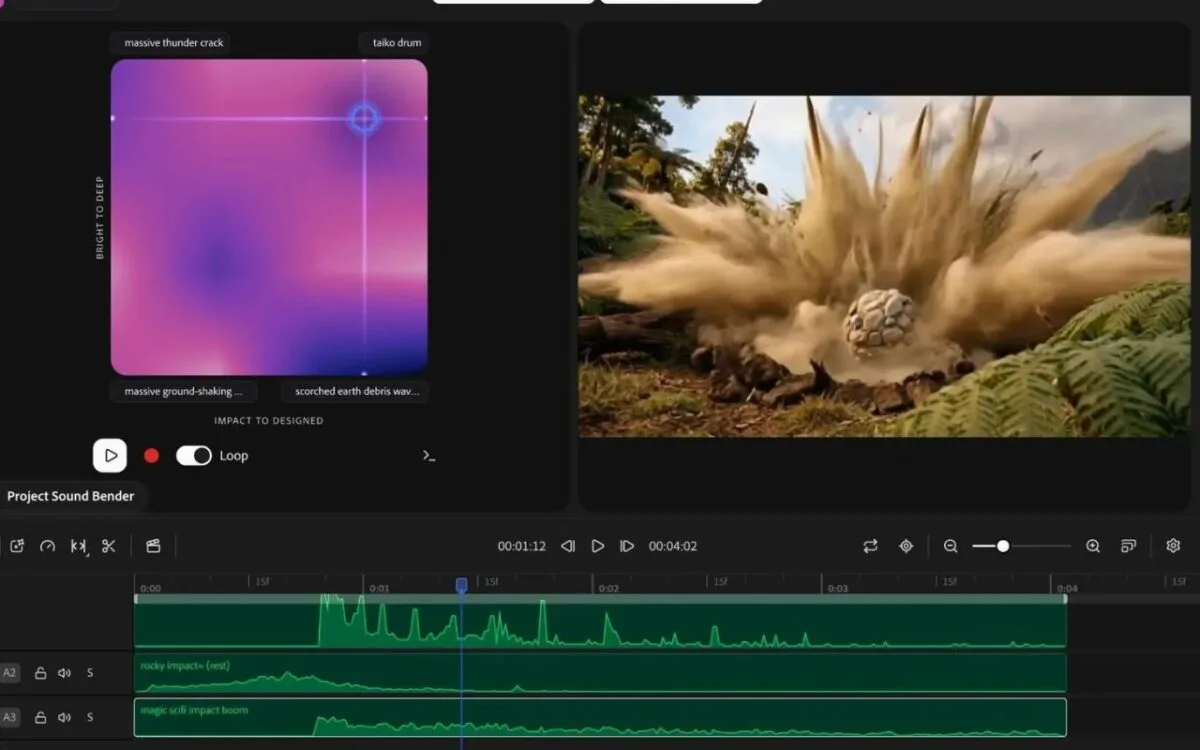
Project Sound Bender برای ساده سازی تولید و میکس جلوه های صوتی طراحی شده است. این ابزار به کاربران اجازه می دهد تا صداهای تولید شده با هوش مصنوعی را از طریق یک محیط گرافیکی کنترل کنند.
روند کار با آپلود یک کلیپ ویدیویی شروع می شود. سپس کاربر صدای مورد نظر را در قالب یک دستور متنی توضیح می دهد. به عنوان مثال، می تواند بخواهد صدای یک دیگ در حال جوشیدن را در یک محیط علمی تخیلی تولید کند.
Sound Bender جلوه های صوتی مربوطه را تولید می کند و به طور خودکار آنها را با ویدیو همگام می کند. سپس یک محیط مربعی برای تنظیم و میکس صداها را نمایش می دهد.
در هر گوشه از این مربع یکی از صداهای تولید شده قرار می گیرد. این صداها می تواند شامل صدای غلیظ، ترکیدن حباب ها، غرش سنگ های در حال جوش یا صدای آتش الکتریکی باشد.
با حرکت دادن نشانگر ماوس در قسمت های مختلف مربع، کاربر می تواند ترکیب افکت های صوتی را تغییر دهد. نزدیک شدن به هر گوشه ای صدای آن قسمت را برجسته تر می کند.
این تغییرات در حین پخش صدا بلافاصله اعمال می شوند. کاربران همچنین می توانند جلوه های صوتی اختصاص داده شده به گوشه های مربع را با صداهای دیگر جایگزین کنند.
نحوه کار Sound Bender بسیار شبیه به انتخاب رنگ از یک پالت دیجیتال است. تفاوت اصلی این است که کاربران به جای ترکیب رنگ ها، صداهای مختلف را تنظیم می کنند.
این فناوری می تواند بخشی از فرآیند پیچیده طراحی صدا را ساده کند و به تولیدکنندگان ویدئو اجازه دهد تا به سرعت ترکیبات مختلف صدا را آزمایش کنند.
بیشتر بخوانید: Adobe قابلیتهای هوش مصنوعی فوتوشاپ و پریمیر را گسترش داد
انتقال خودکار ویرایش های فتوشاپ و آینده ابزارهای هوش مصنوعی Adobe
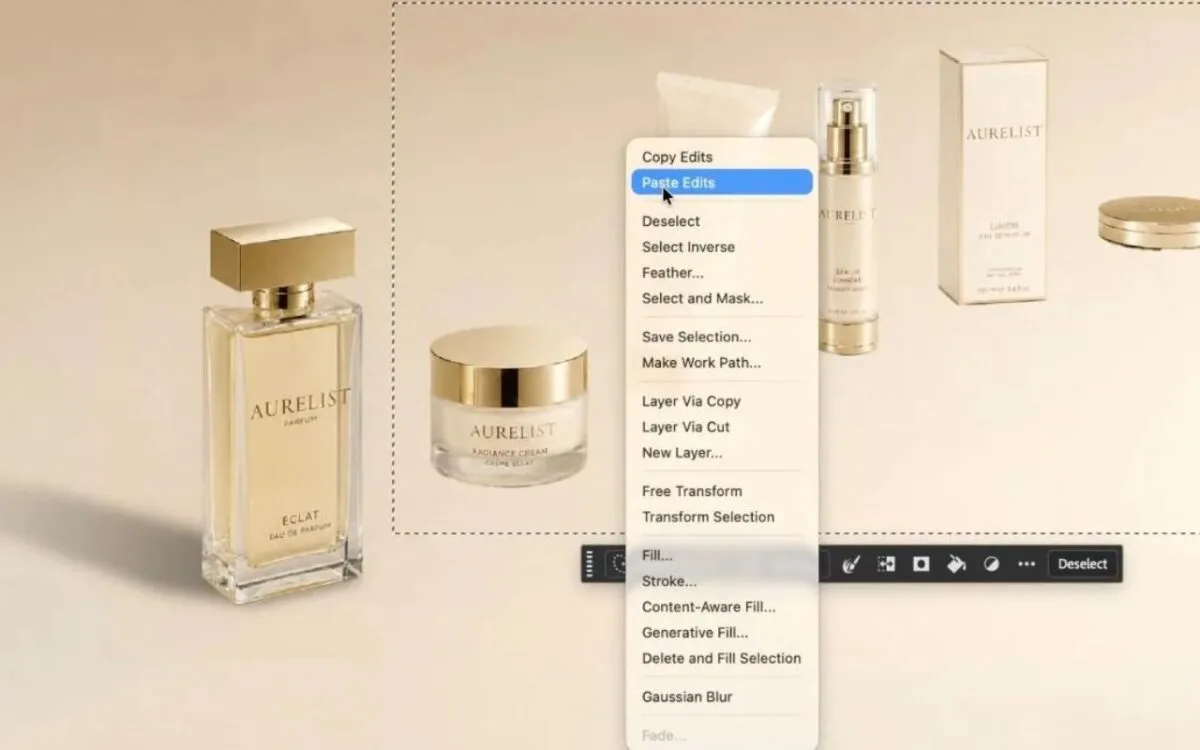
پروژه چهارم، Project Rinse Repeat، برای خودکارسازی ویرایش تکراری تصاویر طراحی شده است. این فناوری به کاربران اجازه می دهد تا فرآیند ویرایش یک موضوع را کپی کنند و همان تغییرات را در ویژگی های موضوعات دیگر اعمال کنند.
به عنوان مثال، اگر کاربر با دقت جوش ها و لک های پوستی را از صورت یک فرد پاک کرده باشد، این ابزار می تواند همان نوع اصلاحات را روی صورت افراد دیگر در عکس گروهی انجام دهد.
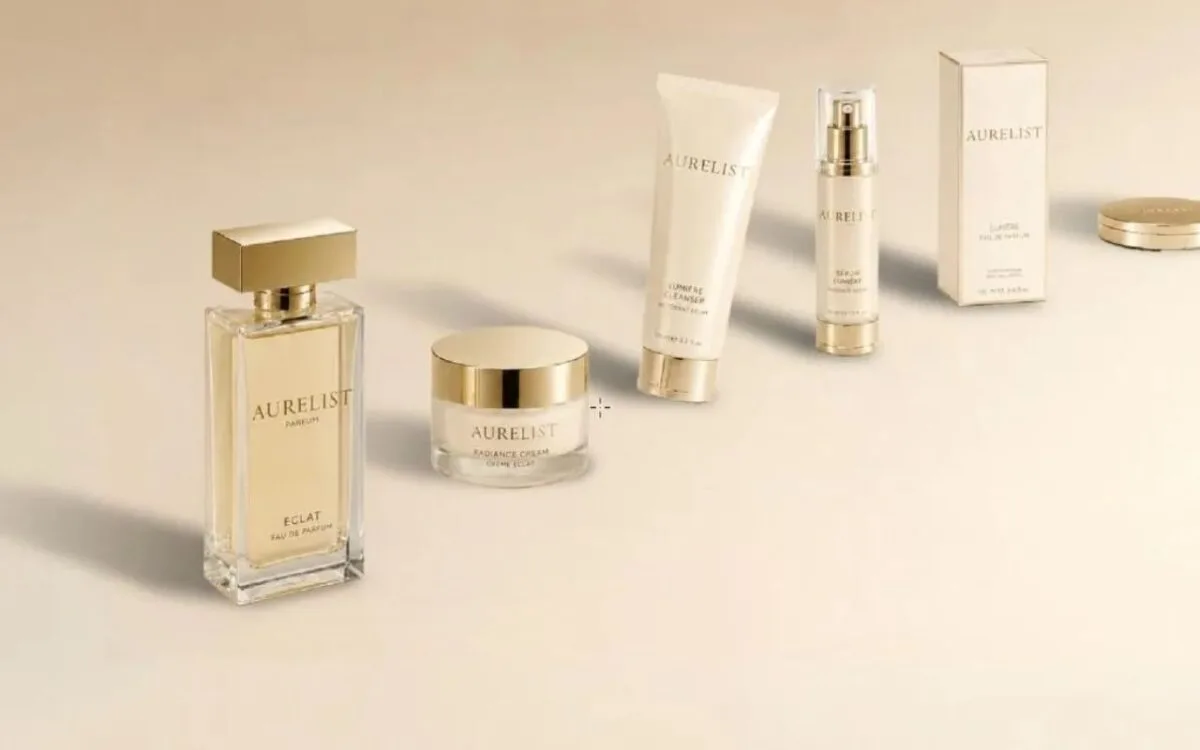
این ویژگی به روتوش چهره محدود نمی شود. طراحان می توانند از آن برای افزودن سایه به محصولات در تصاویر تبلیغاتی استفاده کنند. در این حالت کافی است سایه یک محصول را به صورت دستی بکشید تا ابزار همان فرآیند را برای سایر محصولات تکرار کند.
نکته مهم این است که Rinse Repeat می تواند تغییرات را با اشیاء با اندازه ها و شکل های مختلف تطبیق دهد.
این فناوری بر اساس فتوشاپ توسعه یافته و از ابزارهای داخلی این نرم افزار برای بازگردانی ویرایش ها استفاده می کند. بنابراین، تغییرات ایجاد شده قابل ویرایش باقی می ماند و کاربران می توانند جزئیات خود را تغییر دهند.
Adobe هنوز انتشار عمومی هیچ یک از این چهار پروژه را تایید نکرده است. فناوری های موجود در برنامه Sneaks تنها پیش نمایشی از قابلیت های احتمالی آینده محصولات Creative Cloud و پلتفرم Firefly هستند.
با این حال، هوش مصنوعی به بخش مهمی از استراتژی رشد ادوبی تبدیل شده است و این امکان وجود دارد که برخی از این فناوری ها در آینده به محصولات رسمی این شرکت اضافه شوند.
گسترش چنین قابلیت هایی می تواند بر ابزارهای تولید محتوای سنتی و کتابخانه های تصاویر و افکت های آماده نیز تأثیر بگذارد. اگر ابزارهای هوش مصنوعی به کیفیت کافی برسند، ممکن است جایگزین برخی از روش های فعلی تولید محتوای حرفه ای شوند.
گوتام میسور، محقق ارشد Adobe در مصاحبه با The Verge تاکید کرد که ساده کردن تعامل با ابزارها امکان کنترل دقیق تری را حتی برای متخصصان با تجربه می دهد.
وی قابلیت تنظیم موقعیت دوربین در Sight Span و کاوش تعاملی صدا در Sound Bender را نمونه هایی از این رویکرد دانست.
به گفته میسور، این فناوریها به متخصصان اجازه میدهند تا تجربیات و قضاوت حرفهای خود را مستقیماً برای اصلاح نتایج به کار گیرند. وی ایجاد ارتباط بین هدف خلاقانه کاربر و کنترل دقیق خروجی را یکی از محورهای اصلی پژوهش ادوبی معرفی کرده است.




گفتگو در مورد این post