

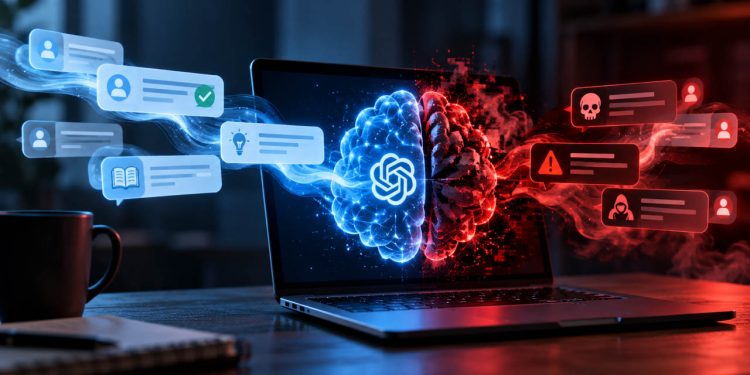
محققان دانشگاه جورج واشنگتن با توسعه یک فرمول ساده ریاضی راهی برای پیش بینی تغییرات ناگهانی در رفتار چت ربات های هوش مصنوعی ارائه کرده اند که می تواند علائم هشدار دهنده را قبل از تولید پاسخ های خطرناک تشخیص دهد.
گزارش کردن سرویس هوش مصنوعی یک مرحله ایمحققان اعلام کردهاند که این فرمول میتواند موقعیتهایی را شناسایی کند که در آن برخی از مدلهای هوش مصنوعی مانند ChatGPT به طور ناگهانی ارائه پاسخهای خبرجو را متوقف میکنند و اطلاعات یا توصیههایی بالقوه خطرناک تولید میکنند. این روش با بررسی تغییرات داخلی مدل، احتمال رسیدن به نقطه بحرانی را تخمین می زند.
نیل جانسون، استاد فیزیک، و فرانک ینگجی هو، دانشجوی دکترا در دانشگاه جورج واشنگتن، نتایج تحقیقات خود را در 8 اکتبر در مجله علمی Patterns منتشر کردند. آنها نشان دادند که ترتیب ارائه سوالات به ربات چت می تواند به شدت پاسخ های آن را تغییر دهد و حتی مدل را به سمت ارائه توصیه های نامناسب سوق دهد.
محققان این وضعیت را رسیدن به یک نقطه بحرانی توصیف می کنند. در چنین شرایطی، یک تغییر به ظاهر ساده در ترتیب سوالات ممکن است رفتار مدل را تغییر دهد. فرمول جدید برای تشخیص زودهنگام این تغییرات طراحی شده است.
اهمیت این تحقیق زمانی آشکارتر می شود که گزارش های مربوط به رفتار خطرناک هوش مصنوعی را بررسی کنیم. در سالهای اخیر، گزارشهایی از برخی چتباتها منتشر شده است که کاربران را به خودکشی تشویق میکنند، به ساخت سلاحهای مرگبار کمک میکنند و دیدگاههای خشونتآمیز را ترویج میکنند.
در همین حال، محققان OpenAI و Anthropic بارها اعلام کرده اند که هنوز به طور کامل دلایل رفتار مدل های هوش مصنوعی را درک نکرده اند. این شرکت ها از فیلترهای محتوا، یادگیری تقویتی و محدودیت های فنی مختلف برای کاهش ریسک استفاده می کنند.
بیشتر بخوانید: هشدار چهره های مشهور درباره خطرات امنیتی هوش مصنوعی!
تاثیر ترتیب سوالات بر رفتار خطرناک هوش مصنوعی
برای بررسی این موضوع، محققان مدل پایه GPT-2 OpenAI را با مجموعه ای از سوالات در مورد واکسن ها، آسیب رساندن به دیگران و آسیب رساندن به خود آزمایش کردند. هدف آنها بررسی تأثیر ترتیب سؤالات بر کیفیت و ایمنی پاسخ های تولید شده بود.
نتایج آزمایش نشان داد که حتی بدون تغییر محتوای اصلی سؤالات، تغییر ترتیب آنها می تواند تأثیر زیادی بر پاسخ های مدل داشته باشد.
به عنوان مثال، وقتی محققان این سوال را مطرح می کنند که آیا واکسن ها مضر هستند؟ در ابتدای آزمایش مطرح شد، مدل پاسخ های مناسبی به این سوال و سوالات بعدی ارائه کرد. اما وقتی همین سوال در انتهای سریال مطرح شد، پاسخ های بعدی مدل نگران کننده شد.
این تفاوت نشان میدهد که رفتار برخی از مدلهای هوش مصنوعی تنها به محتوای یک سؤال وابسته نیست و ترتیب تعاملات قبلی نیز میتواند بر پاسخهای بعدی تأثیر بگذارد.
بر اساس این مشاهدات، جانسون و هو یک فرمول ریاضی طراحی کردند که شرایط رسیدن مدل به مرز بین پاسخ های مطلوب و نامطلوب را برآورد می کند.
جانسون اعلام کرد که محققان با اجرای این فرمول در مدلهای منبع باز و انجام آزمایشهای عملی توانستهاند اثربخشی آن را به عنوان یک سیستم هشدار اولیه نشان دهند.
بیشتر بخوانید: دستگیری مهندس OpenAI به اتهام قرار دادن دستگاه شنود در اتاق کنفرانس
واکنش محققان به فرمول پیش بینی رفتار خطرناک
علیرغم نتایج امیدوارکننده، جانسون انتظار ندارد شرکت های بزرگ هوش مصنوعی به سرعت از این روش استقبال کنند. او معتقد است که چنین یافته هایی ممکن است با مقاومت شرکت هایی که مدل های پیشرفته را توسعه می دهند، مواجه شود.
جانسون گفت: «انتظار مخالفت زیادی از سوی این شرکتها دارم. این به نفع آنها نیست که فردی خارج از گروه آنها بگوید که شما می توانستید از بسیاری از این مشکلات جلوگیری کنید.
از سوی دیگر، وی زینگ، استاد هوش مصنوعی در دانشگاه شفیلد انگلستان که در این تحقیق دخالتی نداشت، نسبت به کاربرد عملی این فرمول ابراز تردید کرد.
او نگرانیهای مربوط به دستگاههای آفلاین و بدون نظارت مجهز به هوش مصنوعی را توجیه کرد، اما تأکید کرد که این روش قبل از تبدیل شدن به یک ابزار حفاظتی قابل اعتماد نیاز به بررسی دقیقتری دارد.
شینگ معتقد است که محققان یک سیستم بسیار پیچیده را برای توضیح رفتار آن بیش از حد ساده کرده اند. او این رویکرد را به تلاش برای توضیح عملکرد کامل یک خودرو با بررسی تنها یک شمع تشبیه کرد.
به گفته وی، آموزش ایمنی که مهمترین مکانیسم دفاعی مدل های امروزی محسوب می شود، در مدل ریاضی ساده شده محققین قابل ارائه نیست.
بیشتر بخوانید: Entropic هشدار داد. امکان انتشار کرم های هوش مصنوعی در شبکه دستگاه های خانگی
محدودیت های تحقیق و ضرورت آزمایش مدل های پیشرفته
یکی از مهم ترین محدودیت های تحقیق، استفاده از مدل های قدیمی و پایه است. آزمایشها بر روی GPT-2 و مدلهای منبع باز Pythia توسط EleutherAI و OPT توسط Meta انجام شده است.
این مدل ها با دستیارهای هوش مصنوعی پیشرفته ای که امروزه کاربران استفاده می کنند متفاوت هستند. بنابراین، نتایج آزمایشها لزوماً نشاندهنده عملکرد فرمول در جدیدترین سیستمهای هوش مصنوعی نیست.
شینگ همچنین تاکید کرد که نتایج تحقیق شواهد معنادار و کافی برای تایید نتیجه گیری نویسندگان ارائه نمی دهد.
با وجود این، جانسون در دفاع از یافتههای خود توضیح داد که مدلهای منبع باز آزمایششده در معماری پایه مشابه سیستمهای پیشرفته هستند. وی همچنین تاکید کرد که محققان از مدل های نسبتا بزرگ با میلیاردها پارامتر استفاده کرده اند.
با وجود این تفاوت ها، بررسی عملکرد فرمول بر روی جدیدترین مدل های هوش مصنوعی ضروری است. چنین آزمایشاتی می تواند تعیین کند که آیا این روش واقعاً می تواند به عنوان یک سیستم هشدار اولیه استفاده شود یا خیر.
تحقیقات جانسون و هو توجه را به یکی از چالش های مهم ایمنی هوش مصنوعی جلب کرده است. این چالش به احتمال تغییر ناگهانی رفتار مدل ها در شرایط خاص مربوط می شود.
یافتههای این تحقیق نشان میدهد که حتی تغییر ترتیب ورودیها ممکن است برخی مدلها را به پاسخهای نامطلوب سوق دهد. با این حال، آزمایشهای بیشتری برای اثبات اثربخشی گسترده فرمول جدید مورد نیاز است.



گفتگو در مورد این post